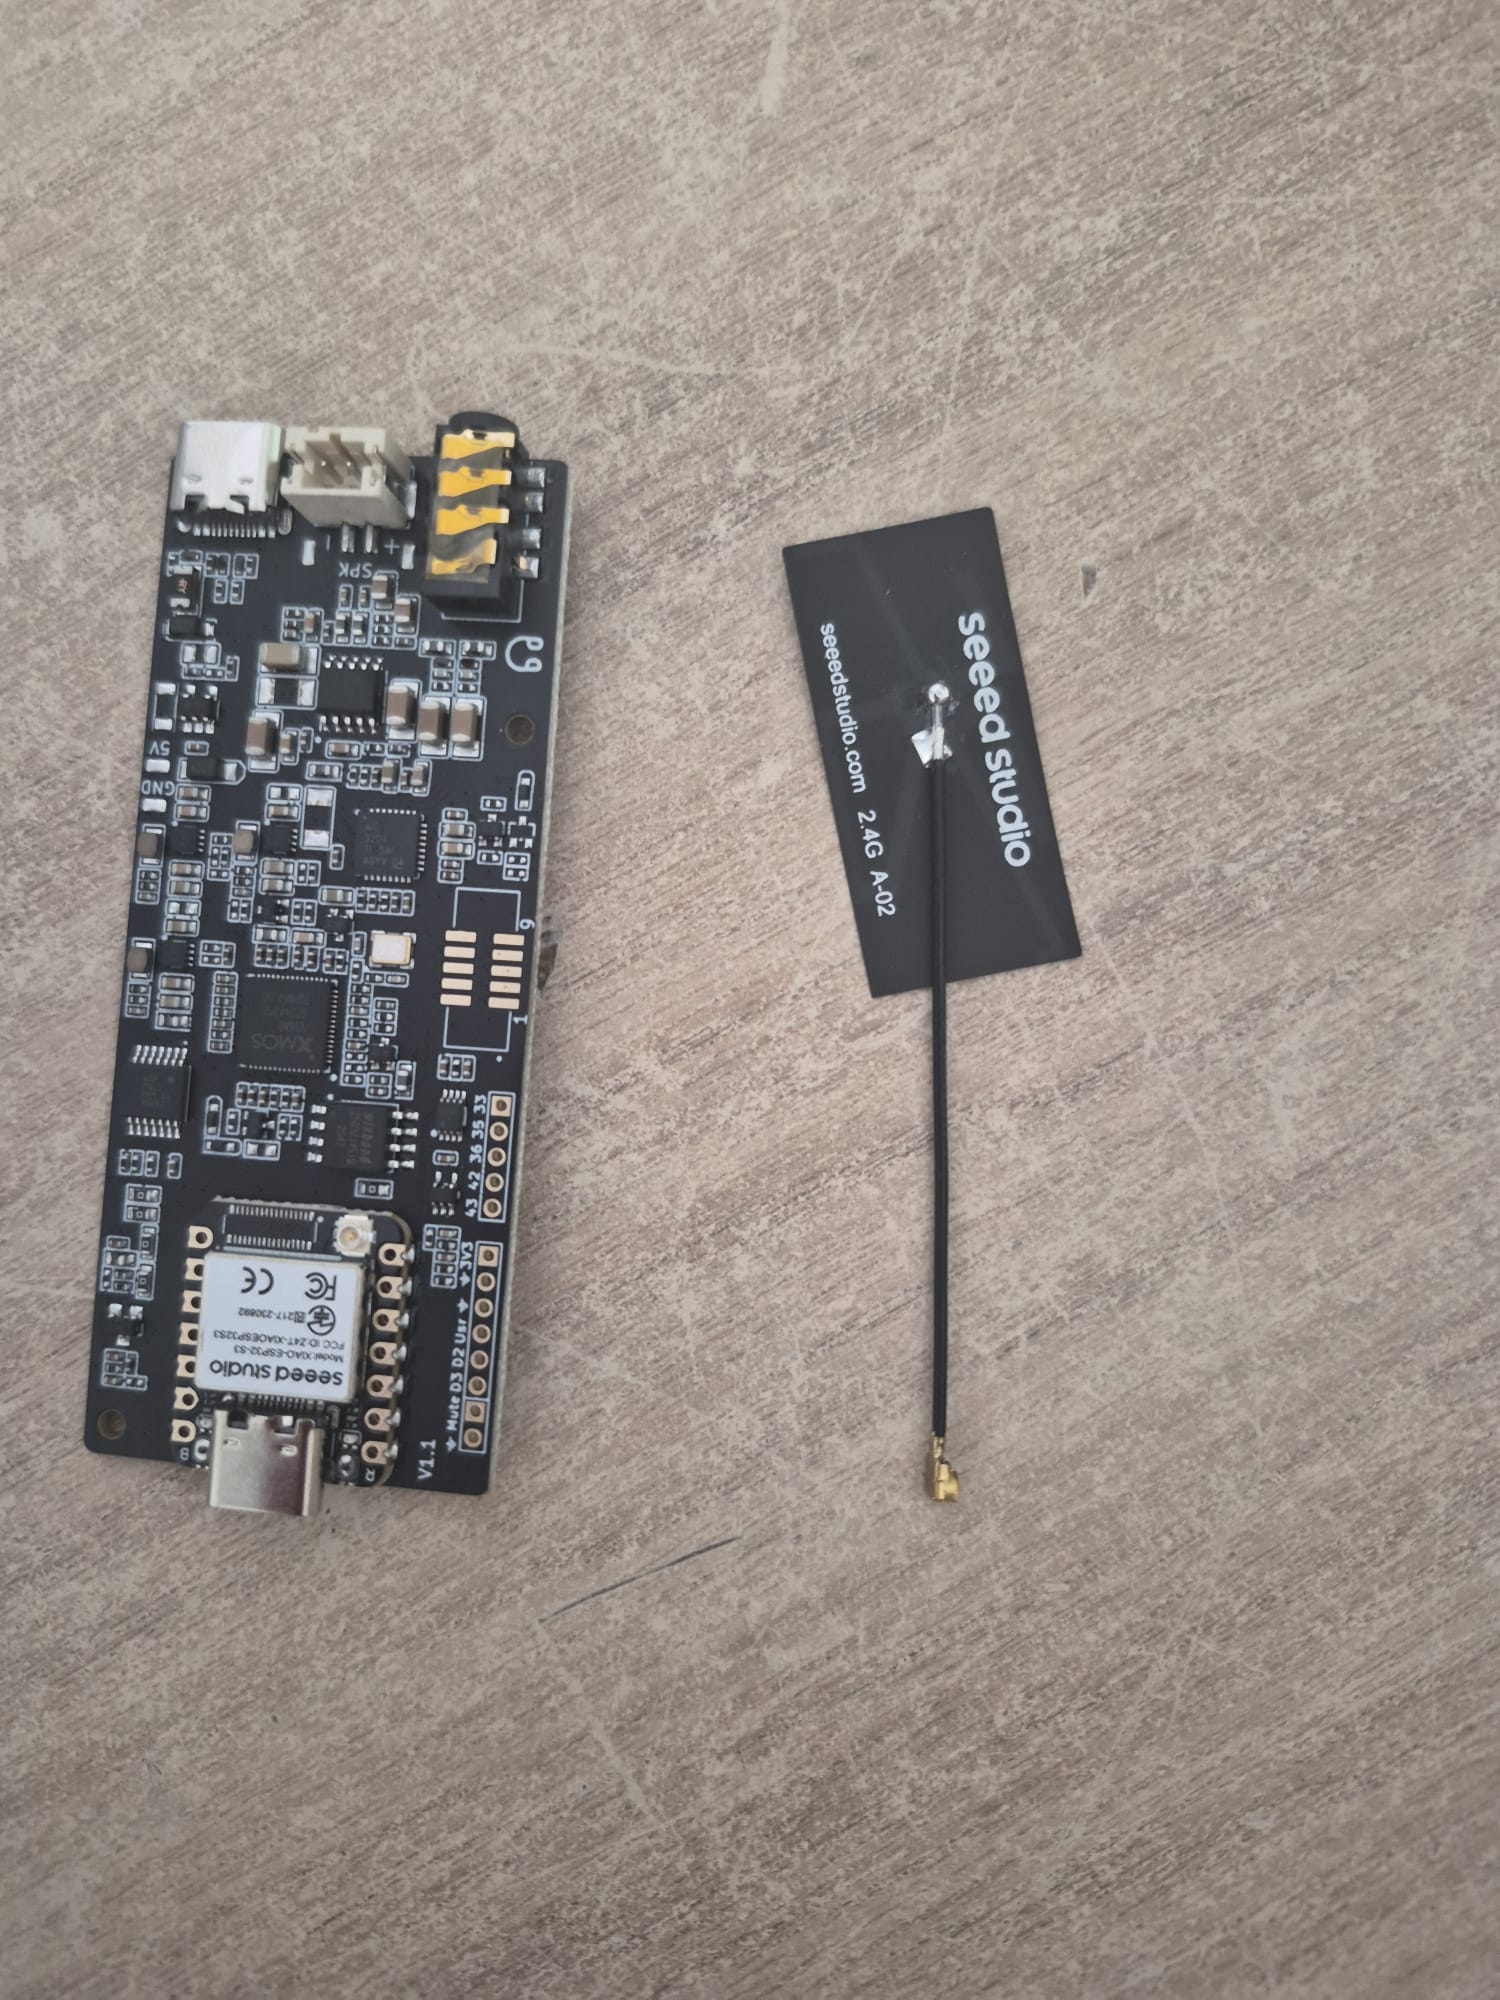
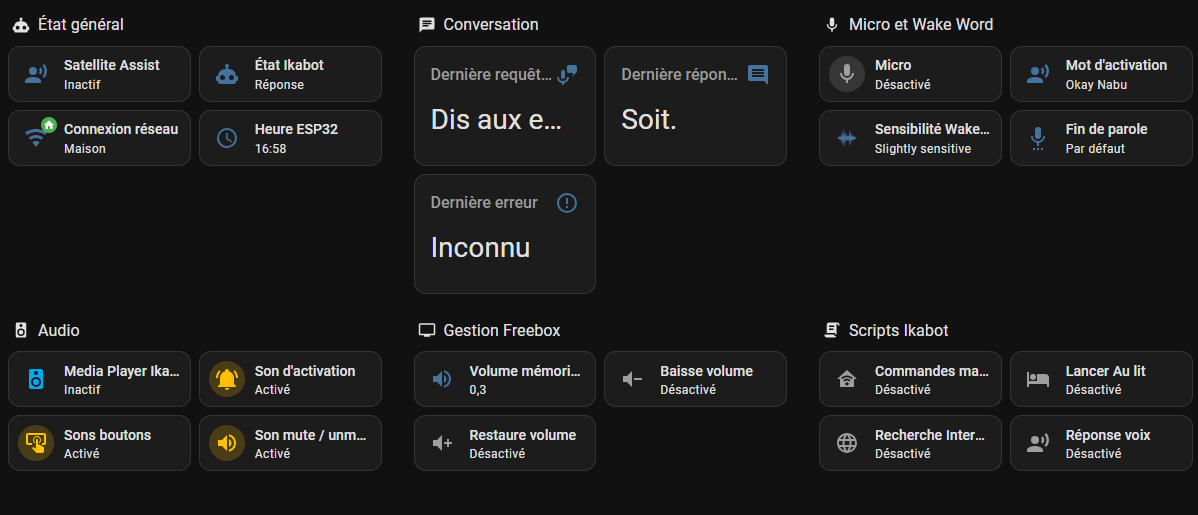
Je travaille actuellement sur un assistant vocal maison appelé Ikabot, basé sur Home Assistant et un ESP32 ReSpeaker Lite.
L’objectif est de créer un assistant vocal vraiment intégré à la maison, avec :
détection locale d’un wake word personnalisé : “Ikabot” ;
utilisation des microphones du ReSpeaker pour la reconnaissance vocale ;
envoi des commandes vers Home Assistant ;
possibilité de piloter les équipements de la maison : lumières, climatisation, volets, musique, etc. ;
réponses vocales avec une voix plus naturelle et expressive qu’un assistant classique ;
lecture des réponses directement sur les enceintes de la maison.
Pour la partie conversation, j’utilise actuellement un pipeline Home Assistant avec un moteur STT et une IA pour comprendre les demandes. Je teste également différents systèmes de STT afin d’améliorer la fiabilité et éventuellement prévoir un système de secours lorsqu’un service échoue.
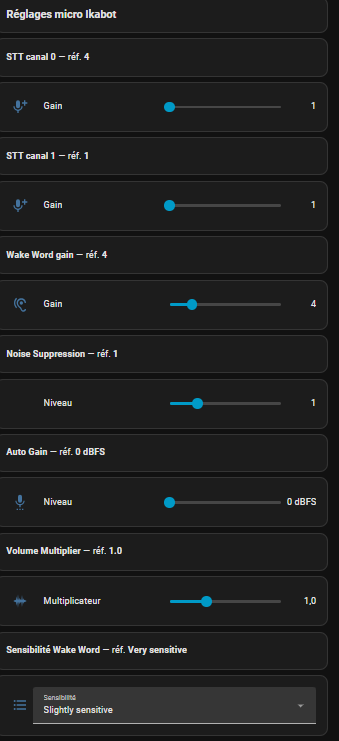
Le ReSpeaker Lite sert principalement de satellite vocal : microphones, détection du wake word et échange avec Home Assistant. J’ai également ajouté dans Home Assistant différents réglages permettant d’ajuster facilement les gains des microphones, le traitement du bruit et d’autres paramètres pendant mes essais.
Une grosse partie du projet concerne actuellement le wake word personnalisé “Ikabot”. J’ai commencé à travailler sur mon propre modèle MicroWakeWord, avec génération et entraînement de données, mais cette partie est encore en développement.
À terme, l’idée est d’avoir plusieurs satellites Ikabot dans la maison et un assistant capable de comprendre des commandes naturelles, contrôler Home Assistant et répondre de façon fluide, avec sa propre personnalité.
Je compléterai ce sujet progressivement avec les configurations, les essais, les problèmes rencontrés et les solutions trouvées.
Maintenant que le projet commence à être réellement utilisable, voici un premier retour un peu plus détaillé sur la mise en place de "Ikabot", mon assistant vocal basé sur Home Assistant et un ESP32 ReSpeaker Lite.
Je précise aussi dès le départ que ChatGPT m’a pas mal aidé, Malgré quelques insultes entre nous lol...
L’objectif ici n’est pas de faire un tutoriel complet clé en main, mais plutôt de partager les grandes étapes, les choix techniques et ce qui a réellement fonctionné chez moi.
Petite précision avant de commencer : j’aurais aimé intégrer directement quelques sons et exemples de voix dans ce post, notamment les sons d’activation et quelques réponses d’Ikabot, mais je n’ai pas encore trouvé de moyen propre de le faire ici. Si quelqu’un connaît une solution simple pour intégrer ou partager de l’audio directement sur le forum, je suis preneur.
Le projet
L’idée de départ était d’aller plus loin qu’un simple assistant capable d’allumer une lampe.
Je voulais un assistant capable à la fois de piloter la maison, de répondre à des questions et d’utiliser les informations déjà présentes dans Home Assistant.
Aujourd’hui, Ikabot peut notamment être utilisé pour :
les lumières, volets, climatisation, chauffage, musique, scripts et scènes ;
répondre à des questions générales ;
donner les prochains passages de bus ;
consulter certaines informations Pronote ;
utiliser les calendriers, tâches et autres données présentes dans Home Assistant.
Je voulais aussi qu’il ait une vraie personnalité. -- Grande importance!!
Le nom est directement inspiré d’Ichabod Crane, personnage principal de la série Sleepy Hollow.
J’aimais bien le personnage, son côté cultivé, très poli, parfois légèrement décalé face au monde moderne, avec une façon de parler assez particulière.
C’est exactement l’esprit que je voulais retrouver dans mon assistant.
J’ai donc repris le nom à ma manière pour arriver à Ikabot.
L’idée n’est évidemment pas de reproduire exactement le personnage de la série, mais de garder cette inspiration : un gentleman cultivé, un peu ancien dans sa façon de s’exprimer, projeté au milieu d’une maison moderne remplie de domotique.
Le matériel : ReSpeaker Lite
Pour le satellite vocal, j’ai choisi un ESP32 ReSpeaker Lite.
Il intègre deux microphones et toute la partie audio nécessaire pour fonctionner comme satellite Home Assistant. -- une trentaine d'euros.
Le principe reste assez simple :
ReSpeaker → Home Assistant → STT → agent conversationnel → TTS → ReSpeaker
L’ESP32 gère surtout la capture audio, le wake word et la lecture de la réponse.
Toute l’intelligence est côté Home Assistant.
J’ai commencé par préparer le ReSpeaker et installer/configurer la partie I2S Audio, nécessaire au fonctionnement de l’audio.
Lien donné par Bob :
Ensuite, je suis parti du projet ESPHome Respeaker-Lite-ESPHome-integration de formatBCE, disponible sur GitHub :
Au début, je voulais surtout valider que l’ensemble fonctionnait correctement avec la configuration d’origine avant de modifier quoi que ce soit.
Une fois le ReSpeaker reconnu, avec le microphone, la sortie audio et l’I2S fonctionnels, j’ai progressivement récupéré le package ReSpeaker en local afin de pouvoir adapter certains comportements à mes besoins et commencer réellement le développement d’Ikabot.
Mon YAML principal sert notamment à gérer :
les gains microphones ;
les paramètres audio ;
les réglages appliqués au démarrage ;
les sons personnalisés ;
certains diagnostics.
Le package local permet ensuite d’aller plus loin, notamment pour modifier certains niveaux sonores ou comportements du satellite.
J’ai par exemple réduit certains sons qui étaient beaucoup trop forts pour une utilisation quotidienne.
J’ai également ajouté des sons MP3 personnalisés générés par Elevenlab pour avoir la même voix..
Un son est joué lorsque le wake word est détecté et que le microphone commence à écouter.
Un autre peut être joué à la fin de l’enregistrement.
Le fichier d’activation est par exemple stocké ici : /config/esphome/sounds/activation/01_oui.mp3
On sait immédiatement quand commencer à parler et quand Ikabot a terminé l’écoute. et pas de TTS à gérer
Je voulais y ajouter des exemples mais je n'y arrive pas ici...
Le réglage des microphones
C’est probablement la partie sur laquelle j’ai passé le plus de temps.
Faire fonctionner les micros est simple.
Obtenir quelque chose de fiable à plusieurs mètres, avec du bruit ambiant et de la réverbération, l’est beaucoup moins.
J’ai donc exposé plusieurs réglages directement dans Home Assistant :
gain STT micro 0 ;
gain STT micro 1 ;
gain wake word ;
noise suppression ;
automatic gain ;
volume multiplier.
Cela me permet de modifier les paramètres puis de tester immédiatement sans reflasher l’ESP32 à chaque fois.
C’est probablement l’outil qui m’a le plus aidé pour régler les micros.
J’ai activé les enregistrements de debug du pipeline Assist.
Les fichiers sont enregistrés dans : /share/assist_pipeline
Je peux ensuite écouter les WAV directement depuis Home Assistant.
Cela permet de déterminer rapidement si un problème vient du micro, du niveau sonore, du bruit ou réellement du moteur STT.
C'est la ou je me suis aperçu que même moi je ne comprenait rien mdr...
Au lieu de modifier les paramètres au hasard, on entend exactement ce que le système reçoit.
Le pipeline vocal
Mon pipeline actuel repose principalement sur :
STT : Google Gemini**
Conversation : Google Gemini**
TTS : ElevenLabs**
Gemini me permet surtout d’utiliser des formulations naturelles sans être obligé de respecter une syntaxe précise.
Je peux par exemple dire :
« J’ai froid dans le salon »
ou :
« Baisse un peu la température »
et laisser l’agent comprendre l’intention et utiliser les entités Home Assistant exposées.
Le choix du TTS ElevenLabs
J’ai testé plusieurs solutions pour le TTS : local, cloud, Gemini, Piper ect....
Beaucoup sont très correctes pour lire une notification, mais deviennent vite trop plates lorsqu’on veut donner une personnalité à l’assistant.
Comparatif rapide des TTS testés :
Piper : très rapide et entièrement local, mais la qualité de voix ne me convenait pas du tout pour Ikabot. Trop synthétique et sans vraiment de caractère.
Gemini TTS : la voix est nettement plus agréable et naturelle, mais chez moi la génération est beaucoup trop lente pour un assistant vocal au quotidien.
ElevenLabs : c’est finalement le meilleur compromis pour mon usage. La qualité de voix est très bonne, la vitesse dépend du modèle choisi, mais même avec un modèle plus expressif cela reste généralement plus réactif que Gemini. Surtout, je le trouve beaucoup plus régulier et fiable à l’usage.
J’ai donc préféré accepter un léger supplément de latence par rapport à Piper pour obtenir une voix qui donne réellement une personnalité à Ikabot.
J’avais d’abord choisi un modèle ElevenLabs très rapide pour réduire au maximum la latence.
Finalement, je suis passé sur un modèle plus lent mais beaucoup plus expressif.
Cela augmente légèrement le temps de réponse, mais la différence est énorme:
Les intonations sont plus naturelles, la voix a beaucoup plus de caractère et Ikabot ressemble enfin vraiment à un personnage plutôt qu’à une simple synthèse vocale.
Pour moi, le petit supplément de latence vaut largement le résultat.
Le prompt
Le prompt a évidemment beaucoup évolué.
Je lui indique notamment :
qu’il répond uniquement à l’oral ;
qu’il doit rester relativement concis ;
qu’il doit prononcer correctement heures, nombres et unités ;
qu’il doit comprendre les formulations familières ou imparfaites ;
qu’il doit exécuter les commandes Home Assistant directement lorsque l’intention est claire ;
et qu’il doit conserver la personnalité d’Ikabot.
Cela évite par exemple qu’une simple demande comme "Éteins la lumière" se transforme en roman philosophique.
Exemple :
les bus
J’ai intégré certaines données GTFS / GTFS Realtime dans Home Assistant.
Des capteurs donnent les prochains passages des lignes qui m’intéressent et un script traite ensuite les données.
Je peux simplement demander :
« Quand passe le prochain bus ? »
Home Assistant utilise alors le bon arrêt, la bonne ligne et le bon sens de circulation.
C’est typiquement le genre d’utilisation que je recherchais : utiliser Home Assistant comme point central, au-delà de la simple domotique.
Même principe avec Pronote.
Certaines informations sont remontées dans Home Assistant et seules les données utiles sont ensuite exposées à l’assistant.
Je peux par exemple demander les dernières notes ou certaines informations scolaires.
L’idée est de ne pas exposer tout Home Assistant au LLM, mais uniquement ce dont il a besoin.
Cela reste beaucoup plus facile à contrôler et à dépanner.
La maison reste évidemment au centre
Ikabot pilote toujours les équipements classiques de la maison :
éclairages ;
volets ;
chauffage ;
climatisation ;
musique ;
scripts ;
scènes.
La vraie différence par rapport aux assistants vocaux classiques est surtout la souplesse du langage.
Je n’ai plus besoin de mémoriser une phrase exacte ou le nom précis d’un appareil.
L’objectif est que l’intention soit comprise.
Surtout, le meilleur reste :
« Ikabot, fais-moi une ambiance romantique. »
Et là, je le laisse improviser : lumières, volets, musique… il gère tout selon son inspiration.
Normalement, avec ça, la soirée avec Madame devrait plutôt bien se passer.
Et le wake word « Ikabot » ?
C’était évidemment l’objectif initial : pouvoir appeler directement l’assistant avec son nom.
J’ai donc commencé à travailler sur un wake word personnalisé avec microWakeWord.
J’ai testé plusieurs approches :
génération de milliers d’échantillons ;
positifs et négatifs ;
augmentation audio ;
pré-calcul des features ;
plusieurs entraînements.
Pour le moment, je n’ai pas réussi à obtenir un résultat suffisamment fiable...
Le principal problème semble venir de la qualité de certaines données générées pour l’entraînement.
Certaines générations censées prononcer « Ikabot » ne ressemblaient parfois même plus à un vrai mot.
Je préfère donc traiter ce sujet séparément.
Je ferai peut être un autre post consacré uniquement au wake word, avec les essais, les erreurs et les différentes pistes testées.
Pour le moment, je préfère continuer à améliorer le plus important :
faire en sorte qu’une fois qu’Ikabot écoute, il comprenne correctement la demande et soit réellement agréable à utiliser.
Et surtout que toute la famille l'adopte !!
Le projet est encore en évolution, donc je suis bien sûr ouvert à toutes vos idées, remarques ou pistes d’amélioration. Si certains ont déjà travaillé sur le ReSpeaker Lite, les pipelines Assist, le TTS ou les wake words personnalisés, vos retours m’intéressent clairement.
Bonsoir,
tu n'as donc pas fait la première étape préconisée pour utiliser le ReSpeaker ?
C'est à dire mettre à jour le firmware de la carte comme indiqué dans mon premier lien ?
Sinon j'utilise "OK Nabu" et ça me convient, chaque mois je regarde sur le deuxième lien que j'ai indiqué si il y a des modifications pour la nouvelle mise à jour de EspHome Builder et si c'est le cas je les intègre à mon fichier yaml, ce qui sera le cas pour la 2026.9.x.
Tu peux aussi tester Microsoft STT et Microsoft TTS
Merci pour ta réponse, vu comment j'ai mis du temps a essayer de résumer tout mon bazar lol.
Oui je l'ai fait également malheureusement je me suis dit que si je détailler trop ce serais trop. J'ai mis le firmware i2s.
J'utilise également ok nabu qui marche très bien. Cest le spici du détail qui me donne envie de le changer.
Bonne idée, Je regarderai les mise a jours et microsoft tts, je connaissais pas. Tu l'utilise? Plus rapide? Le petit point qui m'embête c'est cette latence de 5 a 15 secondes pour le tts...
Si quelqu’un veut plus de détail, je me ferais une joie de l'expliquer
Je n'ai pas cette latence !
Je reviens plus tard avec les log d'une conversations avec le ReSpeaker
pour l'audio sur le forum, non je ne sais pas, insertion fichier peut être dans le menu de l'éditeur.
Des logs de l'ESP32, franchement, à peine fini de parler que l'action est faite et le message diffusé.
23:06:12.921][D][micro_wake_word:493]: Detected 'Okay Nabu' with sliding average probability is 0.85 and max probability is 1.00
[23:06:12.987][D][speaker_source_media_player:285]: State changed to ANNOUNCING
[23:06:13.003][D][ring_buffer:035]: Created ring buffer with size 9600
[23:06:13.021][D][speaker_mixer:369]: Starting
[23:06:13.091][S][media_player]: 'Media Player' >> PLAYING
[23:06:13.091][S][media_player]:   Volume: 35%
[23:06:13.217][D][voice_assistant:615]: State changed from IDLE to START_MICROPHONE
[23:06:13.232][D][voice_assistant:622]: Desired state set to START_PIPELINE
[23:06:13.239][D][voice_assistant:316]: Starting Microphone
[23:06:13.239][D][ring_buffer:035]: Created ring buffer with size 16384
[23:06:13.244][D][voice_assistant:615]: State changed from START_MICROPHONE to STARTING_MICROPHONE
[23:06:13.244][D][voice_assistant:615]: State changed from STARTING_MICROPHONE to START_PIPELINE
[23:06:13.261][D][voice_assistant:340]: Requesting start
[23:06:13.277][D][voice_assistant:615]: State changed from START_PIPELINE to STARTING_PIPELINE
[23:06:13.292][D][voice_assistant:637]: Client started, streaming microphone
[23:06:13.292][D][voice_assistant:615]: State changed from STARTING_PIPELINE to STREAMING_MICROPHONE
[23:06:13.292][D][voice_assistant:622]: Desired state set to STREAMING_MICROPHONE
[23:06:13.292][D][voice_assistant:773]: Event Type: 1
[23:06:13.323][D][voice_assistant:776]: Assist Pipeline running
[23:06:13.323][D][voice_assistant:773]: Event Type: 3
[23:06:13.323][D][voice_assistant:795]: STT started
[23:06:13.778][D][esp-idf:000][md_decoder]: D (3071861) micro_decoder.decoder_source: Decode finished
[23:06:13.782][D][speaker_source_media_player:285]: State changed to IDLE
[23:06:13.878][S][media_player]: 'Media Player' >> IDLE
[23:06:13.878][S][media_player]:   Volume: 35%
[23:06:14.306][D][speaker_mixer:387]: Stopped
[23:06:14.316][D][voice_assistant:773]: Event Type: 11
[23:06:14.317][D][voice_assistant:976]: Starting STT by VAD
[23:06:17.757][D][voice_assistant:773]: Event Type: 12
[23:06:17.764][D][voice_assistant:980]: STT by VAD end
[23:06:17.764][D][voice_assistant:615]: State changed from STREAMING_MICROPHONE to STOP_MICROPHONE
[23:06:17.764][D][voice_assistant:622]: Desired state set to AWAITING_RESPONSE
[23:06:17.764][D][voice_assistant:615]: State changed from STOP_MICROPHONE to STOPPING_MICROPHONE
[23:06:17.786][D][voice_assistant:615]: State changed from STOPPING_MICROPHONE to AWAITING_RESPONSE
[23:06:17.805][D][voice_assistant:773]: Event Type: 4
[23:06:17.813][D][voice_assistant:812]: Speech recognised as: "Allume la lumière de la mezzanine."
[23:06:17.813][D][voice_assistant:773]: Event Type: 5
[23:06:17.825][D][voice_assistant:817]: Intent started
[23:06:17.825][D][voice_assistant:773]: Event Type: 6
[23:06:17.825][D][voice_assistant:773]: Event Type: 7
[23:06:17.825][D][voice_assistant:870]: Response: "Allumé"
[23:06:17.835][D][voice_assistant:773]: Event Type: 8
[23:06:17.835][D][voice_assistant:892]: Response URL: "http://192.168.1.32:8123/api/tts_proxy/YmQsrkbT3oBUEo9hZHb2gQ.flac"
[23:06:17.835][D][voice_assistant:615]: State changed from AWAITING_RESPONSE to STREAMING_RESPONSE
[23:06:17.835][D][voice_assistant:622]: Desired state set to STREAMING_RESPONSE
[23:06:17.849][D][voice_assistant:773]: Event Type: 2
[23:06:17.849][D][voice_assistant:915]: Assist Pipeline ended
[23:06:17.871][D][esp-idf:000][md_reader]: D (3075962) micro_decoder.http_client: Connected: status=200 content-type='audio/flac'
[23:06:17.880][D][esp-idf:000][md_reader]: I (3075962) micro_decoder.audio_reader: Streaming http://192.168.1.32:8123/api/tts_proxy/YmQsrkbT3oBUEo9hZHb2gQ.flac (FLAC)
[23:06:17.917][D][speaker_source_media_player:285]: State changed to ANNOUNCING
[23:06:17.918][D][ring_buffer:035]: Created ring buffer with size 9600
[23:06:17.933][D][speaker_mixer:369]: Starting
[23:06:17.933][D][esp-idf:000][md_reader]: D (3075991) micro_decoder.audio_reader: HTTP read complete
[23:06:17.944][D][esp-idf:000][md_reader]: D (3075992) micro_decoder.decoder_source: Reader finished
[23:06:17.987][S][media_player]: 'Media Player' >> PLAYING
[23:06:17.987][S][media_player]:   Volume: 35%
[23:06:18.819][D][esp-idf:000][md_decoder]: D (3076911) micro_decoder.decoder_source: Decode finished
[23:06:18.825][D][speaker_source_media_player:285]: State changed to IDLE
[23:06:18.834][D][voice_assistant:481]: Announcement finished playing
[23:06:18.839][D][voice_assistant:615]: State changed from STREAMING_RESPONSE to RESPONSE_FINISHED
[23:06:18.848][D][voice_assistant:622]: Desired state set to RESPONSE_FINISHED
[23:06:18.855][D][voice_assistant:615]: State changed from RESPONSE_FINISHED to IDLE
[23:06:18.856][D][voice_assistant:622]: Desired state set to IDLE
[23:06:18.928][S][media_player]: 'Media Player' >> IDLE
[23:06:18.928][S][media_player]:   Volume: 35%
[23:06:19.322][D][speaker_mixer:387]: Stopped
[23:14:38.957][D][micro_wake_word:493]: Detected 'Okay Nabu' with sliding average probability is 0.89 and max probability is 1.00
[23:14:39.021][D][speaker_source_media_player:285]: State changed to ANNOUNCING
[23:14:39.046][D][ring_buffer:035]: Created ring buffer with size 9600
[23:14:39.058][D][speaker_mixer:369]: Starting
[23:14:39.124][S][media_player]: 'Media Player' >> PLAYING
[23:14:39.124][S][media_player]:   Volume: 35%
[23:14:39.255][D][voice_assistant:615]: State changed from IDLE to START_MICROPHONE
[23:14:39.259][D][voice_assistant:622]: Desired state set to START_PIPELINE
[23:14:39.265][D][voice_assistant:316]: Starting Microphone
[23:14:39.265][D][ring_buffer:035]: Created ring buffer with size 16384
[23:14:39.270][D][voice_assistant:615]: State changed from START_MICROPHONE to STARTING_MICROPHONE
[23:14:39.279][D][voice_assistant:615]: State changed from STARTING_MICROPHONE to START_PIPELINE
[23:14:39.299][D][voice_assistant:340]: Requesting start
[23:14:39.308][D][voice_assistant:615]: State changed from START_PIPELINE to STARTING_PIPELINE
[23:14:39.318][D][voice_assistant:637]: Client started, streaming microphone
[23:14:39.318][D][voice_assistant:615]: State changed from STARTING_PIPELINE to STREAMING_MICROPHONE
[23:14:39.318][D][voice_assistant:622]: Desired state set to STREAMING_MICROPHONE
[23:14:39.318][D][voice_assistant:773]: Event Type: 1
[23:14:39.336][D][voice_assistant:776]: Assist Pipeline running
[23:14:39.336][D][voice_assistant:773]: Event Type: 3
[23:14:39.336][D][voice_assistant:795]: STT started
[23:14:39.816][D][esp-idf:000][md_decoder]: D (3577913) micro_decoder.decoder_source: Decode finished
[23:14:39.823][D][speaker_source_media_player:285]: State changed to IDLE
[23:14:39.916][S][media_player]: 'Media Player' >> IDLE
[23:14:39.916][S][media_player]:   Volume: 35%
[23:14:40.348][D][speaker_mixer:387]: Stopped
[23:14:40.894][D][voice_assistant:773]: Event Type: 11
[23:14:40.896][D][voice_assistant:976]: Starting STT by VAD
[23:14:43.163][D][voice_assistant:773]: Event Type: 12
[23:14:43.165][D][voice_assistant:980]: STT by VAD end
[23:14:43.165][D][voice_assistant:615]: State changed from STREAMING_MICROPHONE to STOP_MICROPHONE
[23:14:43.165][D][voice_assistant:622]: Desired state set to AWAITING_RESPONSE
[23:14:43.181][D][voice_assistant:615]: State changed from STOP_MICROPHONE to STOPPING_MICROPHONE
[23:14:43.192][D][voice_assistant:615]: State changed from STOPPING_MICROPHONE to AWAITING_RESPONSE
[23:14:43.249][D][voice_assistant:773]: Event Type: 4
[23:14:43.254][D][voice_assistant:812]: Speech recognised as: "Playlist reggae."
[23:14:43.254][D][voice_assistant:773]: Event Type: 5
[23:14:43.262][D][voice_assistant:817]: Intent started
[23:14:43.276][D][voice_assistant:773]: Event Type: 6
[23:14:43.282][D][voice_assistant:773]: Event Type: 7
[23:14:43.282][D][voice_assistant:870]: Response: "Script démarré"
[23:14:43.288][D][voice_assistant:773]: Event Type: 8
[23:14:43.288][D][voice_assistant:892]: Response URL: "http://192.168.1.32:8123/api/tts_proxy/EaA23XZEGGFDcrDisglJDg.flac"
[23:14:43.288][D][voice_assistant:615]: State changed from AWAITING_RESPONSE to STREAMING_RESPONSE
[23:14:43.288][D][voice_assistant:622]: Desired state set to STREAMING_RESPONSE
[23:14:43.290][D][voice_assistant:773]: Event Type: 2
[23:14:43.290][D][voice_assistant:915]: Assist Pipeline ended
[23:14:43.329][D][esp-idf:000][md_reader]: D (3581426) micro_decoder.http_client: Connected: status=200 content-type='audio/flac'
[23:14:43.333][D][esp-idf:000][md_reader]: I (3581427) micro_decoder.audio_reader: Streaming http://192.168.1.32:8123/api/tts_proxy/EaA23XZEGGFDcrDisglJDg.flac (FLAC)
[23:14:43.363][D][speaker_source_media_player:285]: State changed to ANNOUNCING
[23:14:43.370][D][esp-idf:000][md_reader]: D (3581456) micro_decoder.audio_reader: HTTP read complete
[23:14:43.370][D][esp-idf:000][md_reader]: D (3581459) micro_decoder.decoder_source: Reader finished
[23:14:43.384][D][ring_buffer:035]: Created ring buffer with size 9600
[23:14:43.398][D][speaker_mixer:369]: Starting
[23:14:43.452][S][media_player]: 'Media Player' >> PLAYING
[23:14:43.452][S][media_player]:   Volume: 35%
[23:14:44.618][D][esp-idf:000][md_decoder]: D (3582723) micro_decoder.decoder_source: Decode finished
[23:14:44.623][D][speaker_source_media_player:285]: State changed to IDLE
[23:14:44.637][D][voice_assistant:481]: Announcement finished playing
[23:14:44.641][D][voice_assistant:615]: State changed from STREAMING_RESPONSE to RESPONSE_FINISHED
[23:14:44.650][D][voice_assistant:622]: Desired state set to RESPONSE_FINISHED
[23:14:44.659][D][voice_assistant:615]: State changed from RESPONSE_FINISHED to IDLE
[23:14:44.659][D][voice_assistant:622]: Desired state set to IDLE
[23:14:44.724][S][media_player]: 'Media Player' >> IDLE
[23:14:44.724][S][media_player]:   Volume: 35%
[23:14:45.134][D][speaker_mixer:387]: Stopped
[23:23:20.654][D][micro_wake_word:493]: Detected 'Okay Nabu' with sliding average probability is 0.88 and max probability is 1.00
[23:23:20.733][D][speaker_source_media_player:285]: State changed to ANNOUNCING
[23:23:20.737][D][ring_buffer:035]: Created ring buffer with size 9600
[23:23:20.755][D][speaker_mixer:369]: Starting
[23:23:20.826][S][media_player]: 'Media Player' >> PLAYING
[23:23:20.826][S][media_player]:   Volume: 50%
[23:23:20.964][D][voice_assistant:615]: State changed from IDLE to START_MICROPHONE
[23:23:20.968][D][voice_assistant:622]: Desired state set to START_PIPELINE
[23:23:20.968][D][voice_assistant:316]: Starting Microphone
[23:23:20.968][D][ring_buffer:035]: Created ring buffer with size 16384
[23:23:20.974][D][voice_assistant:615]: State changed from START_MICROPHONE to STARTING_MICROPHONE
[23:23:20.983][D][voice_assistant:615]: State changed from STARTING_MICROPHONE to START_PIPELINE
[23:23:20.996][D][voice_assistant:340]: Requesting start
[23:23:21.009][D][voice_assistant:615]: State changed from START_PIPELINE to STARTING_PIPELINE
[23:23:21.039][D][voice_assistant:637]: Client started, streaming microphone
[23:23:21.039][D][voice_assistant:615]: State changed from STARTING_PIPELINE to STREAMING_MICROPHONE
[23:23:21.039][D][voice_assistant:622]: Desired state set to STREAMING_MICROPHONE
[23:23:21.039][D][voice_assistant:773]: Event Type: 1
[23:23:21.048][D][voice_assistant:776]: Assist Pipeline running
[23:23:21.048][D][voice_assistant:773]: Event Type: 3
[23:23:21.048][D][voice_assistant:795]: STT started
[23:23:21.565][D][esp-idf:000][md_decoder]: D (4099615) micro_decoder.decoder_source: Decode finished
[23:23:21.612][D][speaker_source_media_player:285]: State changed to IDLE
[23:23:21.639][S][media_player]: 'Media Player' >> IDLE
[23:23:21.639][S][media_player]:   Volume: 50%
[23:23:22.047][D][speaker_mixer:387]: Stopped
[23:23:22.075][D][voice_assistant:773]: Event Type: 11
[23:23:22.079][D][voice_assistant:976]: Starting STT by VAD
[23:23:27.520][D][voice_assistant:773]: Event Type: 12
[23:23:27.529][D][voice_assistant:980]: STT by VAD end
[23:23:27.529][D][voice_assistant:615]: State changed from STREAMING_MICROPHONE to STOP_MICROPHONE
[23:23:27.529][D][voice_assistant:622]: Desired state set to AWAITING_RESPONSE
[23:23:27.532][D][voice_assistant:615]: State changed from STOP_MICROPHONE to STOPPING_MICROPHONE
[23:23:27.585][D][voice_assistant:615]: State changed from STOPPING_MICROPHONE to AWAITING_RESPONSE
[23:23:27.606][D][voice_assistant:773]: Event Type: 4
[23:23:27.610][D][voice_assistant:812]: Speech recognised as: "Règle la luminosité de la lumière Marine à 70%."
[23:23:27.616][D][voice_assistant:773]: Event Type: 5
[23:23:27.617][D][voice_assistant:817]: Intent started
[23:23:27.661][D][voice_assistant:773]: Event Type: 6
[23:23:27.667][D][voice_assistant:773]: Event Type: 7
[23:23:27.678][D][voice_assistant:870]: Response: "Luminosité réglée"
[23:23:27.679][D][voice_assistant:773]: Event Type: 8
[23:23:27.679][D][voice_assistant:892]: Response URL: "http://192.168.1.32:8123/api/tts_proxy/AaqnmxTS4i1n_0TvF_GYcA.flac"
[23:23:27.679][D][voice_assistant:615]: State changed from AWAITING_RESPONSE to STREAMING_RESPONSE
[23:23:27.690][D][voice_assistant:622]: Desired state set to STREAMING_RESPONSE
[23:23:27.690][D][voice_assistant:773]: Event Type: 2
[23:23:27.690][D][voice_assistant:915]: Assist Pipeline ended
[23:23:28.756][D][esp-idf:000][md_reader]: D (4106869) micro_decoder.http_client: Connected: status=200 content-type='audio/flac'
[23:23:28.787][D][esp-idf:000][md_reader]: I (4106869) micro_decoder.audio_reader: Streaming http://192.168.1.32:8123/api/tts_proxy/AaqnmxTS4i1n_0TvF_GYcA.flac (FLAC)
[23:23:28.805][D][speaker_source_media_player:285]: State changed to ANNOUNCING
[23:23:28.806][D][ring_buffer:035]: Created ring buffer with size 9600
[23:23:28.806][D][speaker_mixer:369]: Starting
[23:23:28.852][D][esp-idf:000][md_reader]: D (4106951) micro_decoder.audio_reader: HTTP read complete
[23:23:28.862][D][esp-idf:000][md_reader]: D (4106953) micro_decoder.decoder_source: Reader finished
[23:23:28.898][S][media_player]: 'Media Player' >> PLAYING
[23:23:28.898][S][media_player]:   Volume: 50%
[23:23:30.511][D][speaker_source_media_player:285]: State changed to IDLE
[23:23:30.519][D][esp-idf:000][md_decoder]: D (4108625) micro_decoder.decoder_source: Decode finished
[23:23:30.519][D][voice_assistant:481]: Announcement finished playing
[23:23:30.519][D][voice_assistant:615]: State changed from STREAMING_RESPONSE to RESPONSE_FINISHED
[23:23:30.524][D][voice_assistant:622]: Desired state set to RESPONSE_FINISHED
[23:23:30.532][D][voice_assistant:615]: State changed from RESPONSE_FINISHED to IDLE
[23:23:30.542][D][voice_assistant:622]: Desired state set to IDLE
[23:23:30.627][S][media_player]: 'Media Player' >> IDLE
EDIT: je fais simple, c'est ma règle, du fonctionnel sans plus, j'ai aussi un ESP32 N16R8 qui répond encore plus vite en vocal, sans retour audio (en fait on voit ou on entend si tout s'est bien passé), donc l'audio c'est juste pour le fun
Bob
[07:32:13.940][D][micro_wake_word:493]: Detected 'Okay Nabu' with sliding average probability is 0.64 and max probability is 0.78
[07:32:14.187][D][speaker_source_media_player:285]: State changed to ANNOUNCING
[07:32:14.226][D][resampler_speaker:127]: Starting
[07:32:14.226][D][ring_buffer:035]: Created ring buffer with size 9600
[07:32:14.229][D][speaker_mixer:369]: Starting
[07:32:14.229][D][ring_buffer:035][resampler]: Created ring buffer with size 8820
[07:32:14.297][S][media_player]: 'Media Player' >> PLAYING
[07:32:14.297][S][media_player]:   Volume: 94%
[07:32:14.314][D][i2s_audio.speaker:063]: Starting
[07:32:14.318][D][ring_buffer:035][speaker_task]: Created ring buffer with size 38400
[07:32:15.337][D][esp-idf:000][md_decoder]: D (670097) micro_decoder.decoder_source: Decode finished
[07:32:15.337][D][speaker_source_media_player:285]: State changed to IDLE
[07:32:15.339][D][voice_assistant:615]: State changed from IDLE to START_MICROPHONE
[07:32:15.339][D][voice_assistant:622]: Desired state set to START_PIPELINE
[07:32:15.354][D][voice_assistant:316]: Starting Microphone
[07:32:15.354][D][ring_buffer:035]: Created ring buffer with size 16384
[07:32:15.357][D][ring_buffer:035]: Created ring buffer with size 16384
[07:32:15.357][D][voice_assistant:615]: State changed from START_MICROPHONE to STARTING_MICROPHONE
[07:32:15.372][D][voice_assistant:615]: State changed from STARTING_MICROPHONE to START_PIPELINE
[07:32:15.394][D][voice_assistant:340]: Requesting start
[07:32:15.395][D][voice_assistant:615]: State changed from START_PIPELINE to STARTING_PIPELINE
[07:32:15.398][D][voice_assistant:637]: Client started, streaming microphone
[07:32:15.399][D][voice_assistant:615]: State changed from STARTING_PIPELINE to STREAMING_MICROPHONE
[07:32:15.399][D][voice_assistant:622]: Desired state set to STREAMING_MICROPHONE
[07:32:15.403][D][voice_assistant:773]: Event Type: 1
[07:32:15.404][D][voice_assistant:776]: Assist Pipeline running
[07:32:15.404][D][voice_assistant:773]: Event Type: 3
[07:32:15.404][D][voice_assistant:795]: STT started
[07:32:15.406][D][main:599]: IKABOT : nouveau pipeline
[07:32:15.442][S][media_player]: 'Media Player' >> IDLE
[07:32:15.442][S][media_player]:   Volume: 94%
[07:32:15.442][S][text_sensor]: 'Ikabot Etat' >> 'Écoute'
[07:32:15.785][D][resampler_speaker:158]: Stopped
[07:32:15.997][D][speaker_mixer:387]: Stopped
[07:32:16.445][D][voice_assistant:773]: Event Type: 11
[07:32:16.445][D][voice_assistant:976]: Starting STT by VAD
[07:32:19.192][D][voice_assistant:773]: Event Type: 12
[07:32:19.192][D][voice_assistant:980]: STT by VAD end
[07:32:19.192][D][voice_assistant:615]: State changed from STREAMING_MICROPHONE to STOP_MICROPHONE
[07:32:19.192][D][voice_assistant:622]: Desired state set to AWAITING_RESPONSE
[07:32:19.211][D][voice_assistant:615]: State changed from STOP_MICROPHONE to STOPPING_MICROPHONE
[07:32:19.228][D][voice_assistant:615]: State changed from STOPPING_MICROPHONE to AWAITING_RESPONSE
[07:32:19.233][D][speaker_source_media_player:285]: State changed to ANNOUNCING
[07:32:19.235][D][ring_buffer:035]: Created ring buffer with size 9600
[07:32:19.237][D][resampler_speaker:127]: Starting
[07:32:19.239][D][speaker_mixer:369]: Starting
[07:32:19.239][D][ring_buffer:035][resampler]: Created ring buffer with size 8820
[07:32:19.327][S][text_sensor]: 'Ikabot Etat' >> 'Transcription'
[07:32:19.327][S][media_player]: 'Media Player' >> PLAYING
[07:32:19.327][S][media_player]:   Volume: 94%
[07:32:20.546][D][voice_assistant:773]: Event Type: 4
[07:32:20.547][D][voice_assistant:812]: Speech recognised as: "À quelle heure quittent Jeanne et Théo ?"
[07:32:20.547][D][voice_assistant:773]: Event Type: 5
[07:32:20.547][D][voice_assistant:817]: Intent started
[07:32:20.549][I][main:1616]: IKABOT : requete entendue : À quelle heure quittent Jeanne et Théo ?
[07:32:20.654][S][text_sensor]: 'Ikabot Derniere requete' >> 'À quelle heure quittent Jeanne et Théo ?'
[07:32:20.655][S][text_sensor]: 'Ikabot Etat' >> 'Traitement'
[07:32:20.883][D][esp-idf:000][md_decoder]: D (675643) micro_decoder.decoder_source: Decode finished
[07:32:20.885][D][speaker_source_media_player:285]: State changed to IDLE
[07:32:20.986][S][media_player]: 'Media Player' >> IDLE
[07:32:20.986][S][media_player]:   Volume: 94%
[07:32:21.360][D][resampler_speaker:158]: Stopped
[07:32:21.546][D][speaker_mixer:387]: Stopped
[07:32:24.847][D][voice_assistant:773]: Event Type: 100
[07:32:24.847][D][voice_assistant:821]: Intent progress
[07:32:24.851][D][voice_assistant:615]: State changed from AWAITING_RESPONSE to STREAMING_RESPONSE
[07:32:24.851][D][voice_assistant:622]: Desired state set to STREAMING_RESPONSE
[07:32:24.851][D][voice_assistant:773]: Event Type: 6
[07:32:24.851][D][voice_assistant:773]: Event Type: 7
[07:32:24.852][D][voice_assistant:870]: Response: "Ma foi, je ne trouve aucune information concernant les horaires de Jeanne. Quant à Théo, il termine ses cours aujourd'hui à seize heures cinquante-cinq."
[07:32:24.852][D][voice_assistant:773]: Event Type: 8
[07:32:24.852][D][voice_assistant:892]: Response URL: "[https://ma.duckdns.org/api/tts\_proxy/9mn6qtO7MwhGlDLabybwLg.flac](https://ma.duckdns.org/api/tts_proxy/9mn6qtO7MwhGlDLabybwLg.flac)"
[07:32:24.852][D][voice_assistant:773]: Event Type: 2
[07:32:24.853][D][voice_assistant:915]: Assist Pipeline ended
[07:32:24.853][I][main:1610]: IKABOT : texte reponse pret : Ma foi, je ne trouve aucune information concernant les horaires de Jeanne. Quant à Théo, il termine ses cours aujourd'hui à seize heures cinquante-cinq.
[07:32:24.853][I][main:1611]: IKABOT : audio TTS pret : [https://ma.duckdns.org/api/tts\_proxy/9mn6qtO7MwhGlDLabybwLg.flac](https://ma.duckdns.org/api/tts_proxy/9mn6qtO7MwhGlDLabybwLg.flac)
[07:32:24.854][D][script:099]: Script 'keep_playback_timeout_cancelled' restarting (mode: restart)
[07:32:24.856][D][main:397]: IKABOT WATCHDOG : arme
[07:32:24.856][D][main:442]: IKABOT FREEBOX : attente debut TTS
[07:32:24.956][S][text_sensor]: 'Ikabot Derniere reponse' >> 'Ma foi, je ne trouve aucune information concernant les horaires de Jeanne. Quant à Théo, il termine ses cours aujourd'hui à seize heures cinquante-cinq.'
[07:32:24.956][S][text_sensor]: 'Ikabot Etat' >> 'Réponse'
[07:32:27.154][D][esp-idf:000][md_reader]: D (681911) micro_decoder.http_client: Connected: status=200 content-type='audio/flac'
[07:32:27.157][D][esp-idf:000][md_reader]: I (681913) micro_decoder.audio_reader: Streaming [https://ma.duckdns.org/api/tts\_proxy/9mn6qtO7MwhGlDLabybwLg.flac](https://ma.duckdns.org/api/tts_proxy/9mn6qtO7MwhGlDLabybwLg.flac) (FLAC)
[07:32:27.186][D][speaker_source_media_player:285]: State changed to ANNOUNCING
[07:32:27.186][D][main:455]: IKABOT FREEBOX : TTS demarre
[07:32:27.266][D][ring_buffer:035]: Created ring buffer with size 9600
[07:32:27.284][D][speaker_mixer:369]: Starting
[07:32:27.302][S][media_player]: 'Media Player' >> PLAYING
[07:32:27.302][S][media_player]:   Volume: 94%
[07:32:27.355][D][main:416]: IKABOT WATCHDOG : audio demarre - annulation
[07:32:28.202][D][micro_wake_word:056][mww]: Probed tensor arena size: 18256 bytes
[07:32:29.327][D][esp-idf:000][md_reader]: D (684088) micro_decoder.audio_reader: HTTP read complete
[07:32:29.330][D][esp-idf:000][md_reader]: D (684091) micro_decoder.decoder_source: Reader finished
[07:32:34.595][D][esp-idf:000][md_decoder]: D (689357) micro_decoder.decoder_source: Decode finished
[07:32:34.598][D][speaker_source_media_player:285]: State changed to IDLE
[07:32:34.598][D][main:466]: IKABOT FREEBOX : TTS termine - verification continuation
[07:32:34.613][D][voice_assistant:481]: Announcement finished playing
[07:32:34.616][D][voice_assistant:615]: State changed from STREAMING_RESPONSE to RESPONSE_FINISHED
[07:32:34.616][D][voice_assistant:622]: Desired state set to RESPONSE_FINISHED
[07:32:34.631][D][voice_assistant:615]: State changed from RESPONSE_FINISHED to IDLE
[07:32:34.631][D][voice_assistant:622]: Desired state set to IDLE
[07:32:34.701][S][media_player]: 'Media Player' >> IDLE
[07:32:34.701][S][media_player]:   Volume: 94%
[07:32:35.107][D][speaker_mixer:387]: Stopped
[07:32:35.597][W][main:480]: IKABOT FREEBOX : conversation terminee -> restauration volume
[07:36:49.967][D][micro_wake_word:493]: Detected 'Okay Nabu' with sliding average probability is 0.59 and max probability is 0.66
[07:36:50.214][D][speaker_source_media_player:285]: State changed to ANNOUNCING
[07:36:50.252][D][resampler_speaker:127]: Starting
[07:36:50.252][D][ring_buffer:035]: Created ring buffer with size 9600
[07:36:50.255][D][speaker_mixer:369]: Starting
[07:36:50.255][D][ring_buffer:035][resampler]: Created ring buffer with size 8820
[07:36:50.323][S][media_player]: 'Media Player' >> PLAYING
[07:36:50.323][S][media_player]:   Volume: 94%
[07:36:51.156][D][esp-idf:000][md_decoder]: D (945921) micro_decoder.decoder_source: Decode finished
[07:36:51.158][D][speaker_source_media_player:285]: State changed to IDLE
[07:36:51.158][D][voice_assistant:615]: State changed from IDLE to START_MICROPHONE
[07:36:51.158][D][voice_assistant:622]: Desired state set to START_PIPELINE
[07:36:51.174][D][voice_assistant:316]: Starting Microphone
[07:36:51.175][D][ring_buffer:035]: Created ring buffer with size 16384
[07:36:51.175][D][ring_buffer:035]: Created ring buffer with size 16384
[07:36:51.175][D][voice_assistant:615]: State changed from START_MICROPHONE to STARTING_MICROPHONE
[07:36:51.197][D][voice_assistant:615]: State changed from STARTING_MICROPHONE to START_PIPELINE
[07:36:51.209][D][voice_assistant:340]: Requesting start
[07:36:51.212][D][voice_assistant:615]: State changed from START_PIPELINE to STARTING_PIPELINE
[07:36:51.214][D][voice_assistant:637]: Client started, streaming microphone
[07:36:51.216][D][voice_assistant:615]: State changed from STARTING_PIPELINE to STREAMING_MICROPHONE
[07:36:51.216][D][voice_assistant:622]: Desired state set to STREAMING_MICROPHONE
[07:36:51.218][D][voice_assistant:773]: Event Type: 1
[07:36:51.218][D][voice_assistant:776]: Assist Pipeline running
[07:36:51.221][D][voice_assistant:773]: Event Type: 3
[07:36:51.221][D][voice_assistant:795]: STT started
[07:36:51.221][D][main:599]: IKABOT : nouveau pipeline
[07:36:51.272][S][media_player]: 'Media Player' >> IDLE
[07:36:51.272][S][media_player]:   Volume: 94%
[07:36:51.272][S][text_sensor]: 'Ikabot Etat' >> 'Écoute'
[07:36:51.628][D][resampler_speaker:158]: Stopped
[07:36:51.859][D][speaker_mixer:387]: Stopped
[07:36:52.302][D][voice_assistant:773]: Event Type: 11
[07:36:52.302][D][voice_assistant:976]: Starting STT by VAD
[07:36:54.530][D][voice_assistant:773]: Event Type: 12
[07:36:54.531][D][voice_assistant:980]: STT by VAD end
[07:36:54.531][D][voice_assistant:615]: State changed from STREAMING_MICROPHONE to STOP_MICROPHONE
[07:36:54.531][D][voice_assistant:622]: Desired state set to AWAITING_RESPONSE
[07:36:54.547][D][voice_assistant:615]: State changed from STOP_MICROPHONE to STOPPING_MICROPHONE
[07:36:54.565][D][voice_assistant:615]: State changed from STOPPING_MICROPHONE to AWAITING_RESPONSE
[07:36:54.572][D][speaker_source_media_player:285]: State changed to ANNOUNCING
[07:36:54.573][D][ring_buffer:035]: Created ring buffer with size 9600
[07:36:54.575][D][resampler_speaker:127]: Starting
[07:36:54.578][D][speaker_mixer:369]: Starting
[07:36:54.580][D][ring_buffer:035][resampler]: Created ring buffer with size 8820
[07:36:54.646][S][text_sensor]: 'Ikabot Etat' >> 'Transcription'
[07:36:54.646][S][media_player]: 'Media Player' >> PLAYING
[07:36:54.646][S][media_player]:   Volume: 94%
[07:36:55.172][D][esp-idf:000][md_decoder]: D (949937) micro_decoder.decoder_source: Decode finished
[07:36:55.181][D][speaker_source_media_player:285]: State changed to IDLE
[07:36:55.274][S][media_player]: 'Media Player' >> IDLE
[07:36:55.274][S][media_player]:   Volume: 94%
[07:36:55.644][D][resampler_speaker:158]: Stopped
[07:36:55.846][D][speaker_mixer:387]: Stopped
[07:36:55.849][D][voice_assistant:773]: Event Type: 4
[07:36:55.850][D][voice_assistant:812]: Speech recognised as: "Éteins la lumière de la cuisine."
[07:36:55.852][D][voice_assistant:773]: Event Type: 5
[07:36:55.852][D][voice_assistant:817]: Intent started
[07:36:55.852][I][main:1616]: IKABOT : requete entendue : Éteins la lumière de la cuisine.
[07:36:55.885][D][voice_assistant:773]: Event Type: 6
[07:36:55.885][D][voice_assistant:773]: Event Type: 7
[07:36:55.885][D][voice_assistant:870]: Response: "Éteint"
[07:36:55.885][D][voice_assistant:773]: Event Type: 8
[07:36:55.885][D][voice_assistant:892]: Response URL: "https://ma.duckdns.org/api/tts_proxy/Uk2OK3eUo__CCucau89gPg.flac"
[07:36:55.888][D][voice_assistant:615]: State changed from AWAITING_RESPONSE to STREAMING_RESPONSE
[07:36:55.888][D][voice_assistant:622]: Desired state set to STREAMING_RESPONSE
[07:36:55.888][I][main:1610]: IKABOT : texte reponse pret : Éteint
[07:36:55.888][I][main:1611]: IKABOT : audio TTS pret : https://ma.duckdns.org/api/tts_proxy/Uk2OK3eUo__CCucau89gPg.flac
[07:36:55.894][D][main:397]: IKABOT WATCHDOG : arme
[07:36:55.894][D][main:442]: IKABOT FREEBOX : attente debut TTS
[07:36:55.894][D][voice_assistant:773]: Event Type: 2
[07:36:55.894][D][voice_assistant:915]: Assist Pipeline ended
[07:36:55.959][S][text_sensor]: 'Ikabot Derniere requete' >> 'Éteins la lumière de la cuisine.'
[07:36:55.959][S][text_sensor]: 'Ikabot Etat' >> 'Réponse'
[07:36:55.959][S][text_sensor]: 'Ikabot Derniere reponse' >> 'Éteint'
[07:36:58.171][D][esp-idf:000][md_reader]: D (952936) micro_decoder.http_client: Connected: status=200 content-type='audio/flac'
[07:36:58.174][D][esp-idf:000][md_reader]: I (952936) micro_decoder.audio_reader: Streaming https://ma.duckdns.org/api/tts_proxy/Uk2OK3eUo__CCucau89gPg.flac (FLAC)
[07:36:58.175][D][speaker_source_media_player:285]: State changed to ANNOUNCING
[07:36:58.175][D][main:455]: IKABOT FREEBOX : TTS demarre
[07:36:58.187][D][esp-idf:000][md_reader]: D (952952) micro_decoder.audio_reader: HTTP read complete
[07:36:58.190][D][esp-idf:000][md_reader]: D (952954) micro_decoder.decoder_source: Reader finished
[07:36:58.226][D][ring_buffer:035]: Created ring buffer with size 9600
[07:36:58.244][D][speaker_mixer:369]: Starting
[07:36:58.282][S][media_player]: 'Media Player' >> PLAYING
[07:36:58.282][S][media_player]:   Volume: 94%
[07:36:58.391][D][main:416]: IKABOT WATCHDOG : audio demarre - annulation
[07:36:59.205][D][esp-idf:000][md_decoder]: D (953970) micro_decoder.decoder_source: Decode finished
[07:36:59.206][D][speaker_source_media_player:285]: State changed to IDLE
[07:36:59.206][D][main:466]: IKABOT FREEBOX : TTS termine - verification continuation
[07:36:59.223][D][voice_assistant:481]: Announcement finished playing
[07:36:59.226][D][voice_assistant:615]: State changed from STREAMING_RESPONSE to RESPONSE_FINISHED
[07:36:59.226][D][voice_assistant:622]: Desired state set to RESPONSE_FINISHED
[07:36:59.241][D][voice_assistant:615]: State changed from RESPONSE_FINISHED to IDLE
[07:36:59.244][D][voice_assistant:622]: Desired state set to IDLE
[07:36:59.311][S][media_player]: 'Media Player' >> IDLE
[07:36:59.311][S][media_player]:   Volume: 94%
[07:36:59.745][D][speaker_mixer:387]: Stopped
[07:37:00.207][W][main:480]: IKABOT FREEBOX : conversation terminee -> restauration volume
Chez toi c'est une fusée !
Quand ce sont des commandes c'est plutôt rapide aussi par contre quand je demande un peu de generation de parole c'est différent.
Moi j'utilise par contre de la generation de texte via gemini cloud
Puis tts via elevenlab.
Le résultat de la parole est impressionnant
Par contre je passe par mon https duckdns. Je vais modifier ca pour di local déjà. Mais cest bien le tts qui est long
Petite amélioration sur la partie IA ce matin a tester maintenant :
J’essaie surtout d’éviter d’avoir un prompt énorme envoyé à chaque requête.
Du coup j’ai gardé un prompt principal assez léger avec le comportement général d’Ikabot, et je lui fais appeler des scripts Home Assistant seulement quand il a besoin de contexte en plus.
Par exemple j’ai créé un script “Contexte famille”. Il contient les infos utiles sur la famille : liens familiaux, anniversaires, petits traits de caractère, erreurs STT connues, etc.
L’idée, c’est qu’il ne l’appelle pas pour rien. Si je dis “éteins la lumière de la chambre de Théo”, il doit juste faire l’action. Par contre si je demande “quel âge a Théo ?” ou si le STT se trompe sur un prénom, là il va chercher le contexte famille.
Si ça fonctionne bien, je pense faire la même chose pour la musique, le calendrier, etc.
Le but est d’avoir un prompt plus léger, plus facile à maintenir, et de ne charger les détails que quand ils sont réellement utiles.
Par contre j'ai du mal à te suivre, les mots utilisés peut être ?
Le package ReSpeaker en local
Si tu parles du YAML EspHome, il est évidemment en local !!!
Le prompt a évidemment beaucoup évolué.
De quel prompt parles tu ? Pour moi le seul prompt c'est la transcription de la voix en texte.
J'ai des scripts qui sont appelés par l'assistant mais parce
qu'ils sont exposés et ont des alias !
Des automatisations de ce type aussi :
alias: Vocal information musique
description: ''
mode: single
triggers:
  - command:
      - Information musique
    trigger: conversation
conditions: []
actions:
  - if:
      - condition: device
        device_id: 0e520b023b2718652b775e0af47697c6
        domain: media_player
        entity_id: 7dbc06581894b1cbf12393e33543e6b0
        type: is_playing
    then:
      - set_conversation_response: >-
          L'artiste
          {{state_attr('media_player.denon_avc_x3700h','media_artist')}} chante
          {{state_attr('media_player.denon_avc_x3700h','media_title')}} de
          l'album,
          {{state_attr('media_player.denon_avc_x3700h','media_album_name')}}.
          Mode d'écoute,
          {{state_attr('media_player.denon_avc_x3700h_2','sound_mode')}}. Bonne
          journée Bruno
    else:
      - set_conversation_response: Il n'y a pas de musique en cours d'écoute
J'ai l'impression que tu montes une usine non ?
Ikabot c'est quoi, juste le petit nom de ton assistant ou il y a autre chose dérrière ?
Bob
Ikabot est un gros projet pour moi. Ce n’est pas juste « ferme le volet », ça Alexa le fait déjà très bien, donc aucun intérêt de refaire la même chose... moi je veux un assistant vivant!
J’ai ajouté Gemini, ElevenLabs, des scripts HA, du contexte familial, des sons locaux, des réglages micros et pas mal de logique autour des commandes et des erreurs. Donc oui, c’est un peu plus usine
Mais le but, c’est justement d’avoir un assistant beaucoup plus complet et personnalisé, tout en retrouvant la rapidité que tu as sur les commandes simples.
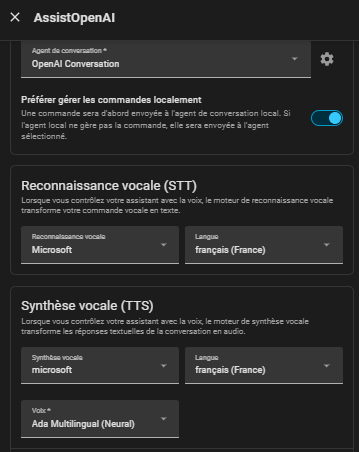
Et quand je parle de prompt, je parle bien des instructions données à l’agent de conversation, pas du STT.
Merci Bob pour tes remarques ca me fait avancer!
Le fichier respeaker-satellite-base.yaml contient toute la base technique du ReSpeaker Lite : micro, haut-parleur, wake word, LED, audio, etc.
Dans ikabot.yaml, je l’importe simplement et je garde uniquement mes réglages et ma logique perso.
J'aurais peut être du le laisser tranquille. Je vais revoir l'architecture plus simple.
Ok, je vois mieux, n'hésite pas à mettre des captures pour que ce soit plus clair.
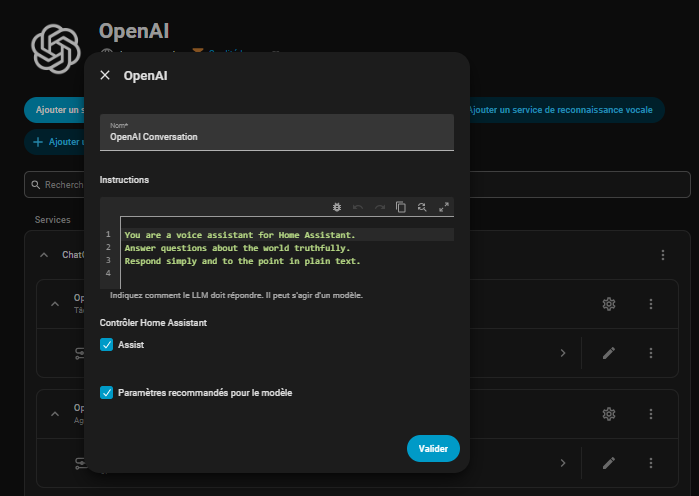
Comme ceci donc dans le cas d'OpenAI, prompt del'agent de conversation.
Ikabot commence vraiment à prendre forme, et je dois dire que ça devient franchement bluffant.
Les progrès les plus marquants ces derniers jours :
la domotique est devenue beaucoup plus fiable, avec des actions plus directes et moins de retours inutiles ;
les réponses sont maintenant mieux adaptées à la personne de la famille qui parle, avec récupération du contexte uniquement quand c’est nécessaire ;
la latence globale s’est nettement améliorée, notamment entre la fin de la phrase et l’exécution de l’action ;
la gestion de la musique avec Music Assistant est beaucoup plus propre ;
les scripts commencent à être mieux structurés pour éviter de bloquer l’assistant pendant les scénarios longs ;
les enregistrements WAV du pipeline m’aident enfin à régler les micros de façon beaucoup plus précise.
Il reste encore du travail sur le wake word, les micros et quelques cas particuliers, mais on commence vraiment à sortir du simple projet de test pour arriver à un assistant utilisable au quotidien.
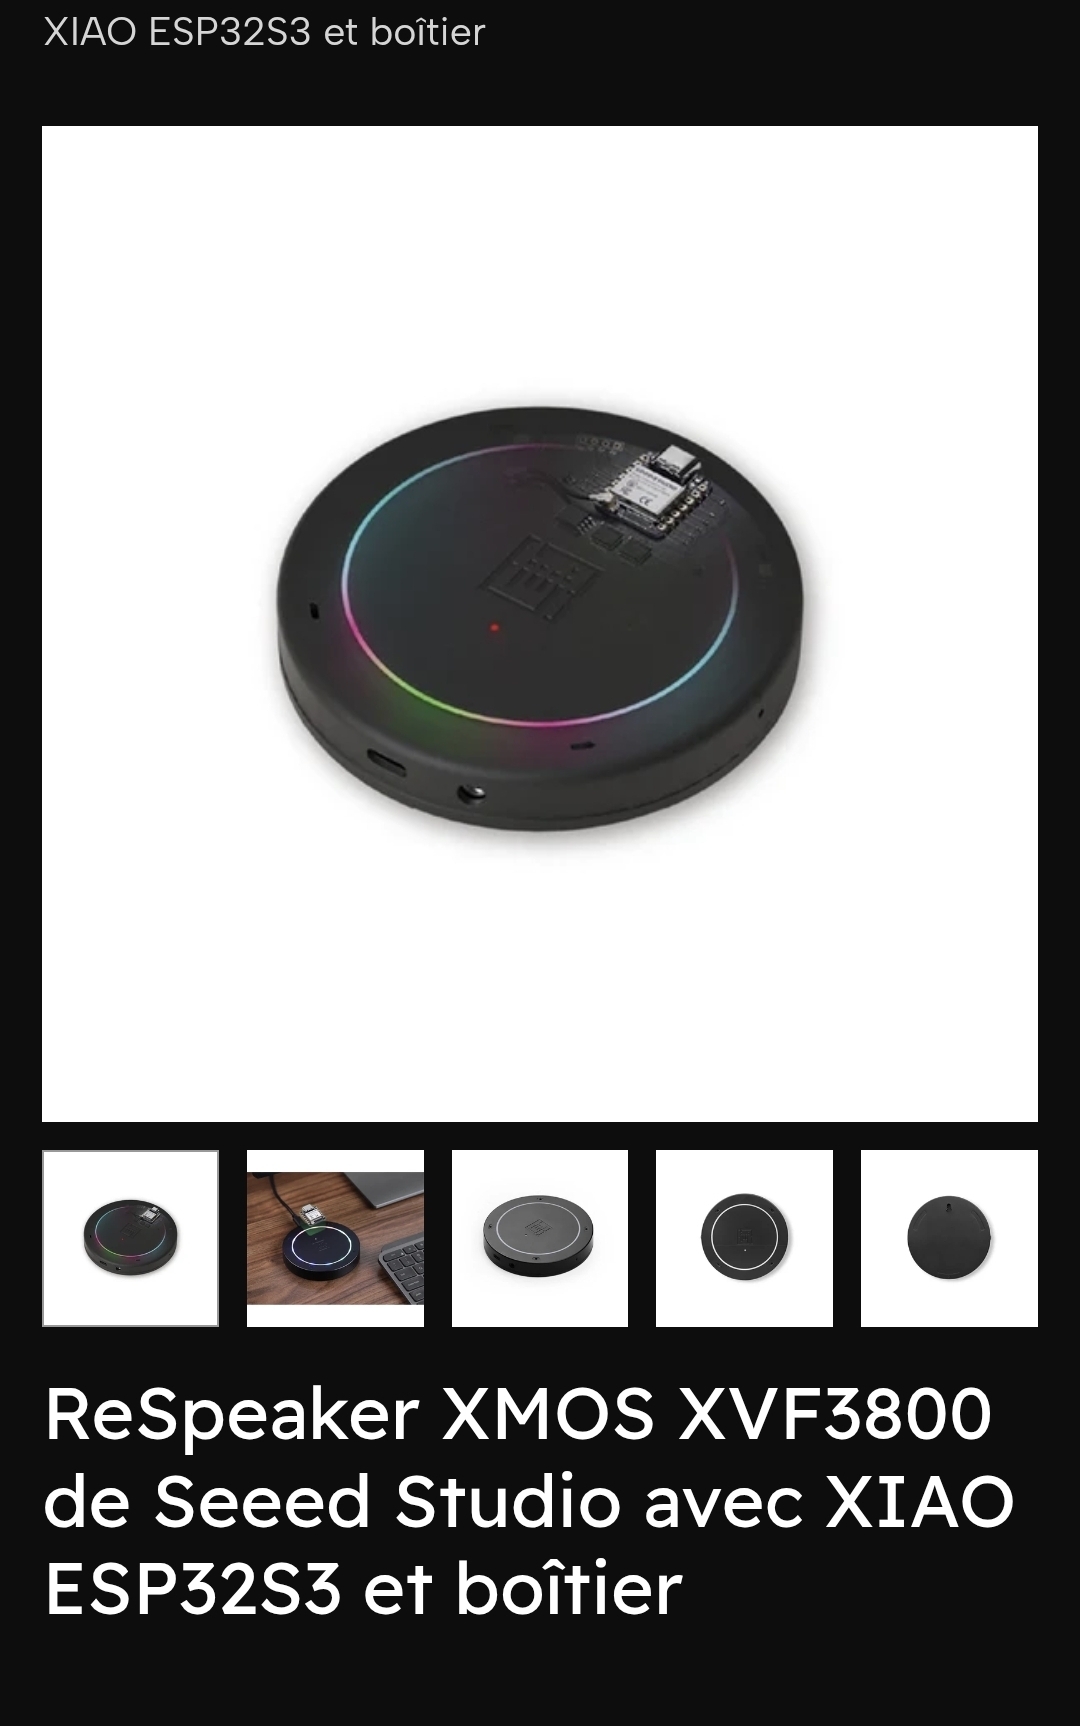
Maintenant que ca marche plutôt bien je passe a du plus gros. Je vais remplacer mon respeaker par un XVF3800 que je vais mettre sur mon plafond
En photo :
Petit retour. Le XVF3800 c'est clairement un autre niveau!
Je reviendrais pas en arrière la gestion d'écoute est au top!
Du coup je suis partit sur un projet de fabriquer une enceinte connecté en y intégrant le XVF3800 et bien d'autres choses dedans dont météo et petit écran rond
Tous les element sont en commande.
Imprimante 3d en fonctionnement
Je vous mettrais des photos pour ceux que ca intéresse.