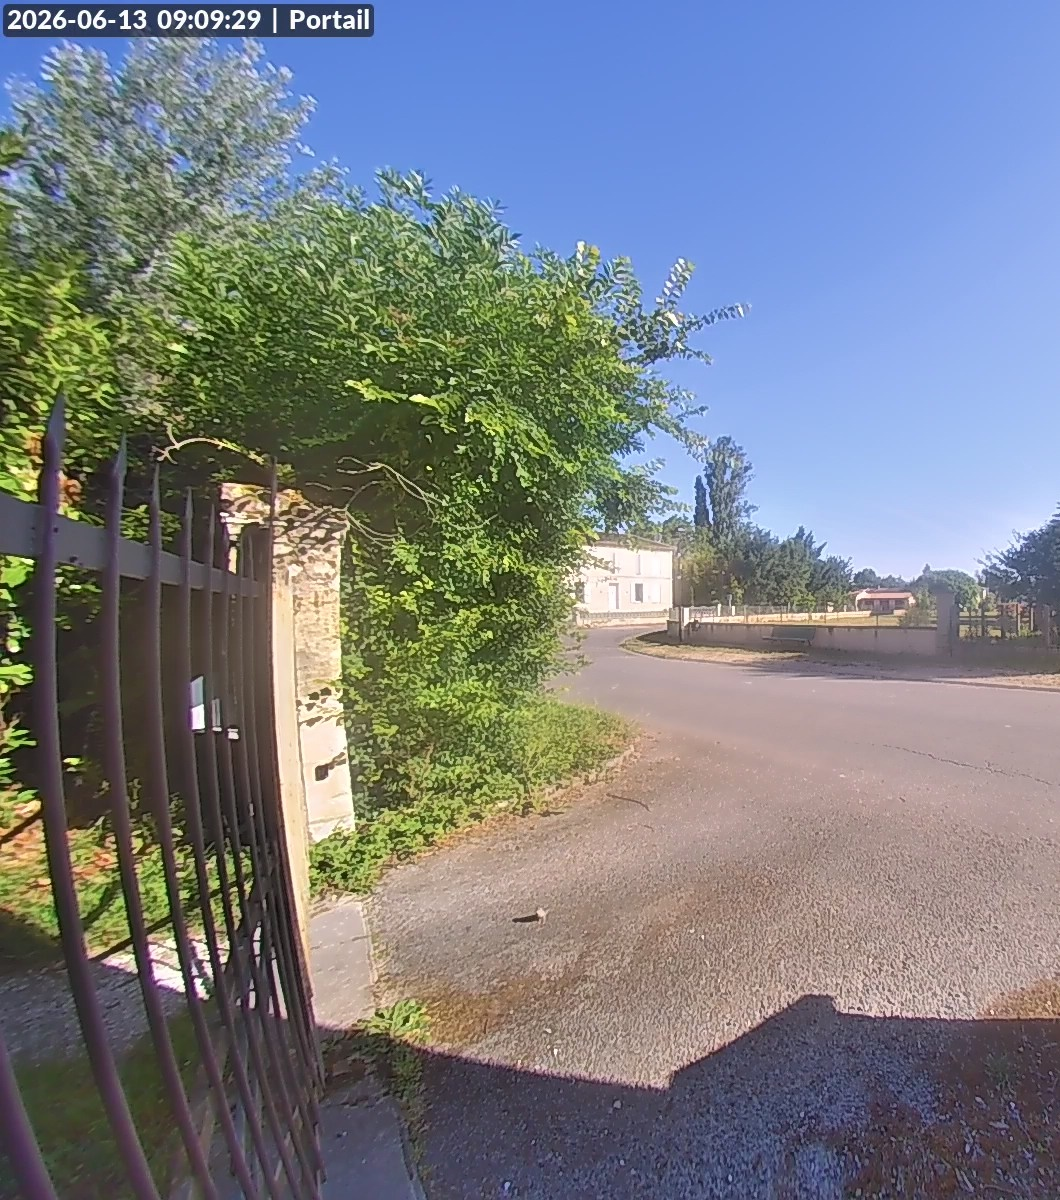
Tout est parti d'une question toute bête : en partant le matin, est-ce que j'ai bien refermé
le portail ? Ma sonnette le voit de côté, alors plutôt que poser un contact magnétique et
tirer un câble, je me suis demandé si la caméra pouvait pas me le dire elle-même.
Verdict : ça marche, ça tourne sur un Raspberry Pi et ça remonte un binary_sensor dans Home
Assistant. Mais le plus intéressant, c'est pas le résultat, c'est le chemin : la difficulté
qui m'a coûté le plus de temps n'a rien à voir avec le modèle.
L'idée de départ : classer, pas détecter
Premier réflexe quand on parle « caméra + IA », c'est de sortir l'artillerie lourde, genre
YOLO et la détection d'objets. Ici c'est inutile : j'ai pas besoin de localiser le portail,
juste de savoir s'il est ouvert ou fermé. C'est une simple classification binaire
d'image, le cas le plus basique en vision par ordinateur, et un petit modèle de ce genre
tient sans souci sur un Pi au format TFLite.
Le projet s'est vite découpé en deux briques : une « fabrique » pour produire le modèle
(récupérer des images, les étiqueter, entraîner), et un « runtime » pour le faire tourner
et l'exposer dans Home Assistant. On va suivre les deux.
Étape 1 : récupérer des images (peu importe ta caméra)
Avant la technique, posons ce qui compte vraiment. Pour entraîner ce genre de modèle, t'as
besoin de deux choses, et deux seulement :
- pouvoir extraire des images de ta caméra ;
- avoir des candidats dans toutes les situations : ouvert et fermé, de jour et de
nuit, beau temps comme pluie.
Le reste (la marque de la caméra, l'API) c'est du détail. Chez moi c'est une UniFi Protect,
mais que tu sois sur une Reolink en RTSP, une ESP32-CAM ou n'importe quel flux, la démarche se
transpose telle quelle. Ce que je raconte en dessous, c'est surtout des pièges sur la façon
de constituer le jeu de données, et ceux-là, ils sont universels.
Trouver les « ouvert » : l'état rare
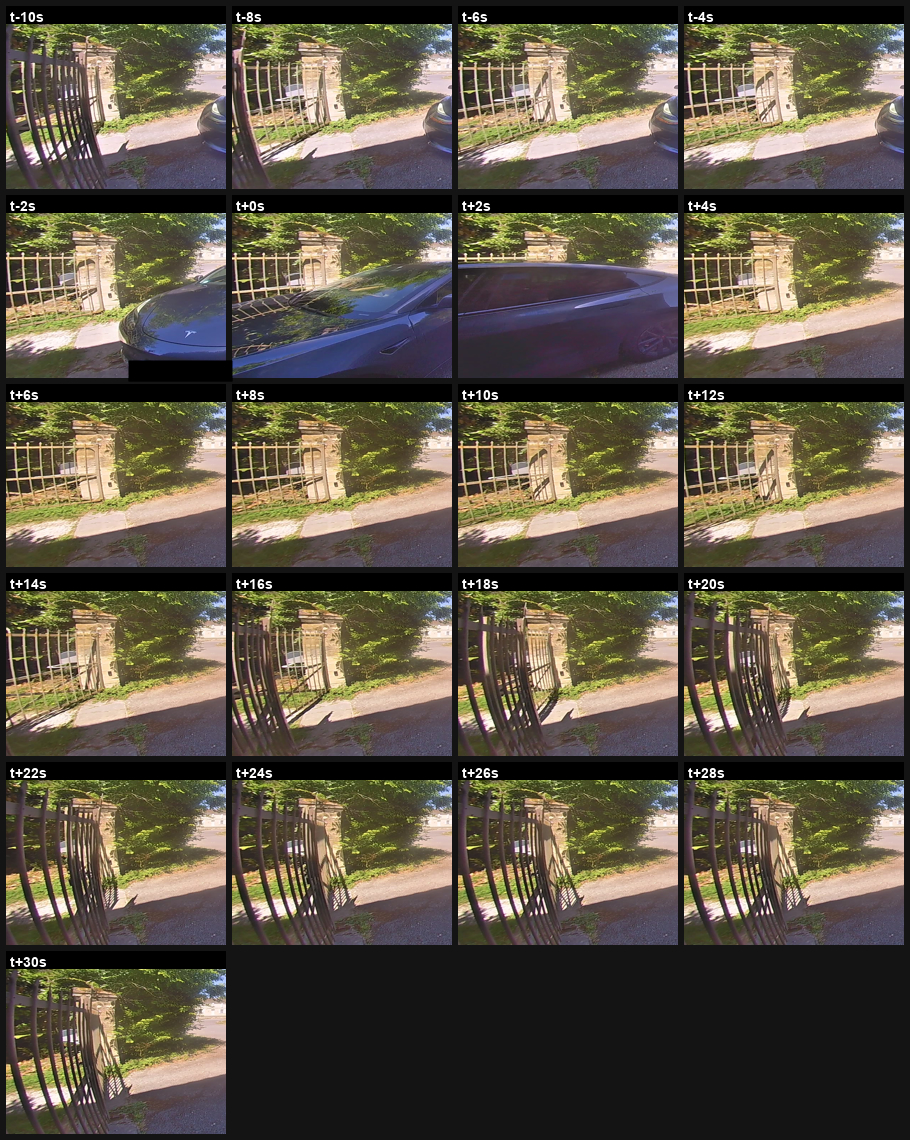
Le portail change d'état seulement quand quelque chose passe. L'idée, donc : cibler les
moments où ça bouge plutôt qu'éplucher des heures de vidéo. Chez moi, la caméra horodate
déjà ses détections ; je télécharge un court clip autour de chacune et j'en extrais quelques
images plein cadre. (Au passage : les vignettes de détection, recadrées sur l'objet,
servent à rien ici, la voiture masque le portail. Faut bien du plein cadre.)
Au total, près de 1900 images sur cinq semaines.
L'astuce qui change tout : un signal qui garantit l'état
Une détection « dans la zone » se déclenche aussi pour une voiture qui passe sur la route,
donc portail fermé. Bruité. La parade, si ta caméra ou ton NVR le propose : la ligne de
franchissement, un fil virtuel posé en travers de l'entrée. Un franchissement garantit
que le portail est ouvert. Et c'est le principe qui compte, transposable à n'importe quel
setup : tout signal qui te garantit l'état (un fil, un autre capteur, une plage horaire)
te récolte des exemples déjà fiables, sans étiquetage à l'aveugle.
Chez moi, prendre les quelques secondes autour de ces franchissements a fait passer ma classe
« ouvert » propre de quelques dizaines à plusieurs centaines d'images.
Le piège contre-intuitif : trop d'« ouvert »
Là je me suis fait avoir : mon jeu de données était massivement ouvert, alors que dans la
vraie vie le portail est fermé 99 % du temps. Logique, en fait : je capturais que des
événements, c'est-à-dire des passages, c'est-à-dire des portails ouverts. L'état fermé au
repos, lui, déclenche rien, donc il était jamais capturé.
La parade : un simple timelapse de l'enregistrement continu, une image toutes les 50
minutes sur deux semaines. Au repos le portail est fermé, et je récupère des centaines de
« fermé » dans toutes les lumières : jour, crépuscule, et surtout nuit en infrarouge.
Mieux encore : la capture déterministe
Dernière source, la plus maligne : mon portail est piloté par un script Home Assistant qui
envoie une impulsion (un toggle). En partant d'un état que je connais et en comptant les
impulsions, je sais dans quel état est le portail sans avoir à le deviner sur l'image :
fermé (confirmé) -> impulsion -> ouvert -> capture -> impulsion -> fermé -> capture
Parfait pour aller chercher les conditions qui manquaient (plein soleil de midi, nuit) avec
des étiquettes garanties justes.
Étape 2 : garder des images représentatives
Les clips d'événements produisent des rafales d'images quasi identiques, et le timelapse
ajoute des centaines de « fermé » qui se ressemblent énormément. Bref, des milliers d'images
dont une grosse part de quasi-doublons. Pas la peine de tout étiqueter à la main.
J'ai donc dédupliqué : pour chaque image, une petite empreinte (32×32 en niveaux de gris),
une distance pixel à pixel, et je garde une image seulement si elle est suffisamment
différente de toutes les précédentes. L'astuce, c'est que cette distance conserve la variété
de lumière (le jour et la nuit restent très différents) tout en écrasant les rafales d'un
même passage.
Résultat : le volume est divisé par trois ou quatre, sans rien perdre des situations
réelles. De quoi rendre l'étiquetage à la main raisonnable.
Étape 3 : l'étiquetage, le vrai nerf de la guerre
Si tu retiens une seule chose de cet article, c'est celle-là : la réussite se joue ici, bien
plus que dans le choix du modèle.
Pourquoi ça se fait à la main
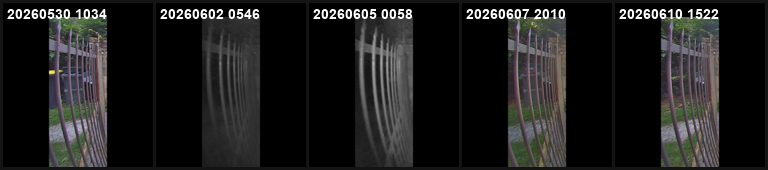
On aimerait automatiser, mais le signal est plus subtil qu'il n'y paraît. La clôture
fixe est toujours dans le cadre : ses barreaux verticaux sont là que le portail soit ouvert
ou fermé. Donc « y'a des barreaux » veut pas dire « c'est fermé », et toute attribution
automatique naïve se casse les dents dessus. Ajoute les images de transition (vantail en plein
mouvement) et les passages où une voiture masque tout : il faut clairement un œil humain
pour trancher proprement.
Le vrai repère, une fois qu'on le connaît :
- fermé : le vantail barre l'ouverture, ce sont les barres courbes et obliques (l'arche du portail) ;
- ouvert : il reste que les barreaux verticaux droits, et l'allée est dégagée.
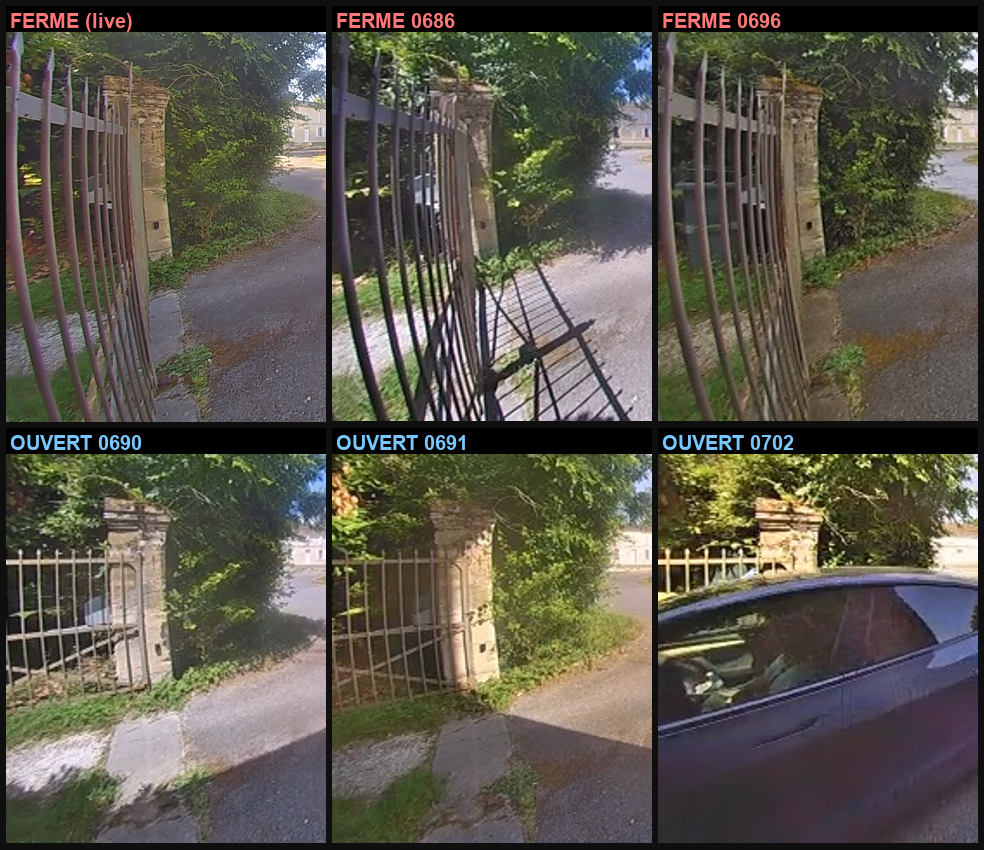
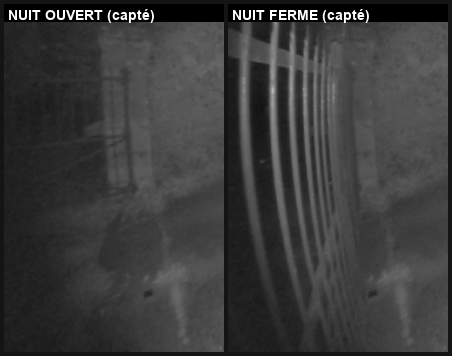
Et la nuit, l'infrarouge fait briller le métal : c'est même plus lisible qu'en plein jour.
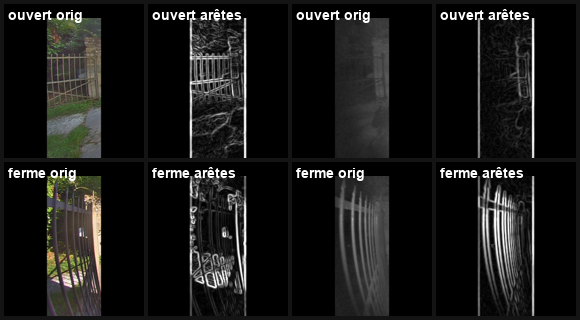
Tant qu'on y est : le signal est purement géométrique. Si on transforme l'image en carte
d'arêtes, les barres ressortent et le jour ressemble à la nuit. J'en ai pas eu besoin au
final (des étiquettes propres ont suffi), mais c'est une bonne carte à garder dans la manche
si la lumière vient à poser problème :
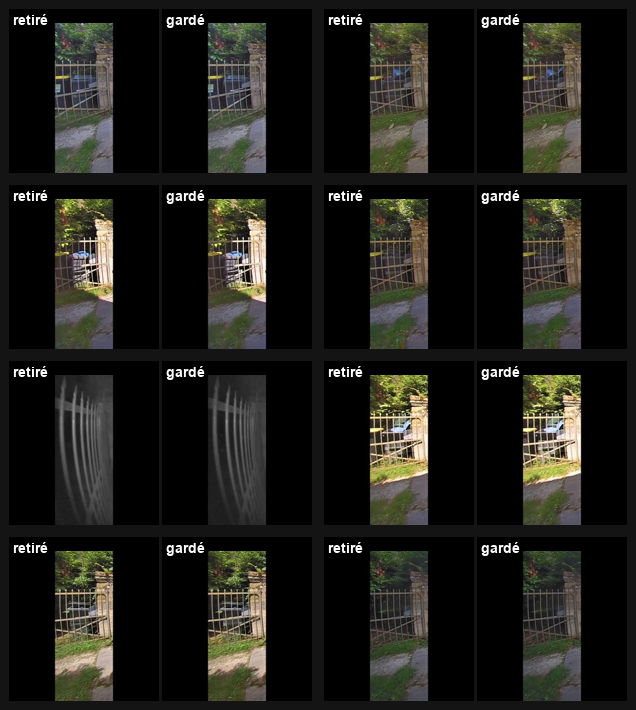
La stratégie : pré-trier, puis confirmer d'un clic
Étiqueter des centaines d'images une par une, c'est pas tenable. Ma stratégie tient en deux
temps. D'abord regrouper automatiquement les images qui se ressemblent (un simple
clustering sur la zone du vantail) : ça donne une pré-classification déjà à peu près
juste. Ensuite valider à la main, mais vite. Pour ça j'ai bricolé une mini interface
web (en Python pur, sans aucune dépendance) : une grille de vignettes pré-classées, et un
clic suffit pour basculer une image d'ouvert à fermé. Deux boutons en plus pour les cas « en
transition » (vantail en mouvement) et « à exclure » (voiture qui masque tout).
Le contraste a été net : avec des étiquettes bâclées je plafonnais à 75 % en validation ;
après cette passe manuelle soignée (525 ouvert / 218 fermé), la précision a bondi à
99 %. C'était pas le modèle qui coinçait, c'était le bruit dans les étiquettes. Je le
répète parce que c'est contre-intuitif : sur un signal subtil, des labels propres valent dix
réglages de modèle.
Dataset ouvert

Dataset fermé
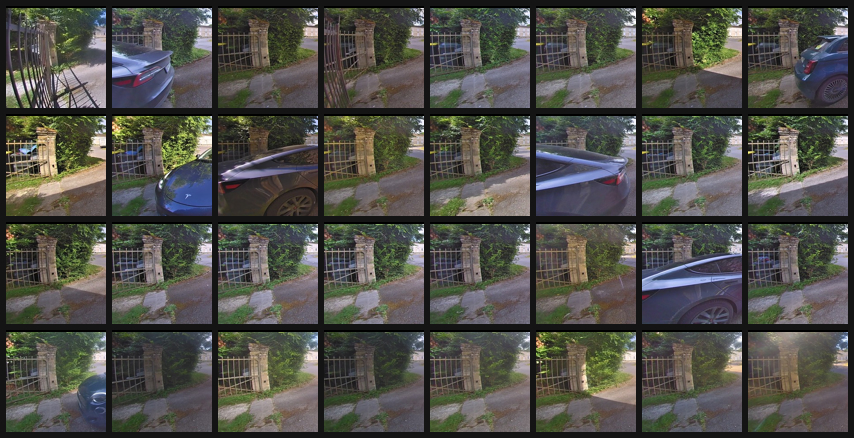
Le modèle reste binaire. Les images de transition, je les supprime pas, je les mets de
côté : les deux classes restent propres, et le mouvement sera géré plus tard par un lissage au
moment de l'inférence.
Étape 4 : la zone d'intérêt et le prétraitement
On donne pas toute l'image au modèle, juste la zone qui change. Je la définis en
fractions de l'image (et pas en pixels), comme ça elle marche quelle que soit la
résolution : exports basse def, flux haute def, peu importe. Concrètement c'est une bande
verticale à gauche, centrée sur le vantail.
Petit soin qui compte : comme la zone est très allongée, je l'écrase pas en carré (ça
déformerait les barreaux). Je la pose sur un carré noir (padding) avant de redimensionner
en 224×224. Zéro déformation, et un format que le modèle pré-entraîné aime bien.
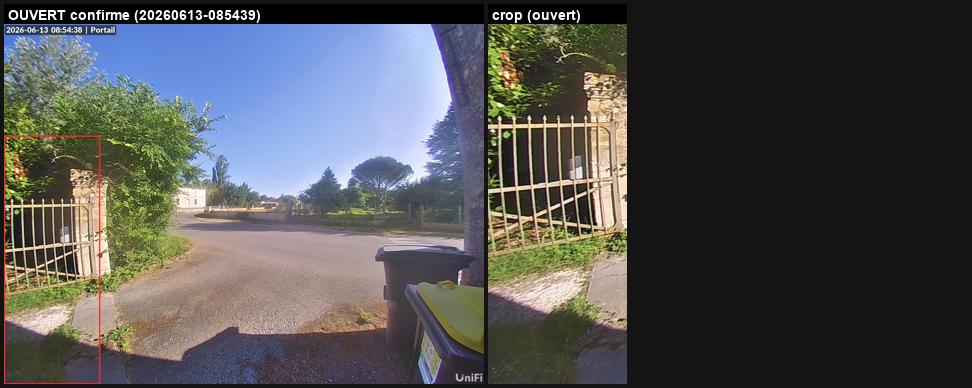
Le même code de prétraitement sert à l'entraînement et à l'inférence, sinon dérive assurée
entre ce qu'on apprend et ce qu'on prédit.
Étape 5 : entraîner le modèle
Rien d'exotique, et tant mieux :
- transfer learning sur MobileNetV3-Small (pré-entraîné sur ImageNet) : on gèle le
gros du réseau, on apprend juste une petite tête binaire, puis on dégèle les dernières
couches pour affiner ; - des poids de classe pour gérer le déséquilibre (plus d'« ouvert » que de « fermé ») sans
jeter d'images ; - de l'augmentation (luminosité, contraste, zoom) mais surtout pas de miroir
horizontal : la géométrie gauche/droite du portail, c'est justement le signal ; - l'export en TFLite : une version
int8(1,2 Mo) et unefp16(1,9 Mo). C'est lafp16
que je garde pour le Pi, elle se charge proprement partout.
Côté résultats : 99 % en validation, et surtout 6 sur 6 en test réel en pilotant le
portail (ouvert détecté à 0,999, fermé à 0,03 : des marges énormes).
Et une autre leçon au passage, parce qu'elle m'a bien eu : un bon score de validation, ça
peut mentir. Une de mes premières versions s'en sortait correctement sur le papier, et se
plantait lamentablement en vrai sur « portail ouvert sans voiture au crépuscule », un cas que
les données couvraient quasiment pas. Seul un test en conditions réelles l'a révélé. Teste
toujours en vrai.
Étape 6 : l'intégrer à Home Assistant
Plutôt que coder un truc jetable « spécial portail », j'ai fait un add-on générique : on
lui décrit une liste de détecteurs (caméra, modèle, zone, étiquettes), et chaque
détecteur devient un capteur. Déposer un nouveau .tflite et ajouter une ligne de config
suffit à créer un capteur, sans rien recompiler. (Mon prochain projet : détecter s'il y a
quelqu'un dans la piscine, avec exactement la même recette.)
Le schéma est tout simple :
caméra HA -> add-on (TFLite + lissage) -> GET /state -> binary_sensor REST -> Home Assistant
L'add-on expose un petit endpoint GET /state en JSON, qu'un binary_sensor de type rest
vient lire côté Home Assistant. Et comme l'add-on récupère l'image depuis Home Assistant
lui-même (via le proxy caméra et le jeton du Superviseur), y'a aucun identifiant de caméra
à stocker.
Un piège m'a fait perdre du temps ici : le jeton du Superviseur arrivait vide dans mon
script. Les images de base de Home Assistant utilisent s6-overlay, qui transmet pas
l'environnement au service sans with-contenv. Une fois le service lancé comme il faut, le
jeton était là et tout s'est mis à marcher.
Pour finir j'ai créé une entité cover (type portail) : son état vient du capteur, et ses
boutons ouvrir/fermer déclenchent le script toggle. Avec l'option optimistic, l'UI réagit
tout de suite au clic, puis se cale sur le capteur une quinzaine de secondes plus tard (le
temps de l'inférence, du lissage et du rafraîchissement). Et bien sûr, on peut l'exposer à
Alexa pour demander « est-ce que le portail est ouvert ? ».
Ce que j'en retire
Si tu te lances dans un projet de vision à la maison, voilà ce que je garderais :
- Les étiquettes d'abord. Le plus gros gain est pas venu du modèle, mais d'une passe de
validation à la main, à un clic. - Comprends ton signal. Le bon repère (barres courbes contre verticales) venait du
terrain, pas de l'algo, et une carte d'arêtes aide à le visualiser. - Méfie-toi de ta façon d'échantillonner. Capturer que des événements m'a noyé sous
l'« ouvert » ; il a fallu un timelapse du repos pour rééquilibrer. - Teste en vrai. La validation hors-ligne suffit pas.
- Sépare la fabrique du runtime. Un add-on générique transforme un bricolage en plateforme
réutilisable.
Au final : une petite caméra, un modèle de 2 Mo, et une question de moins le matin en partant.
Côté outils : UniFi Protect, uiprotect, Python (avec uv), scikit-learn, TensorFlow/Keras,
TFLite, MobileNetV3-Small, et Home Assistant (add-on Docker, capteur REST, template cover).



 ).

 ). C'est ce dataset qui fait la robustesse du modèle, bien plus que l'architecture. Pour que ça reste soutenable, je me suis outillé : clustering automatique pour pré-trier les images, puis une petite UI web locale pour valider ou corriger chaque label en un clic. Le modèle entraîné est ensuite chargé dans un add-on custom (que je pourrais sans doute publier