Bonjour la communauté,
Mon problème
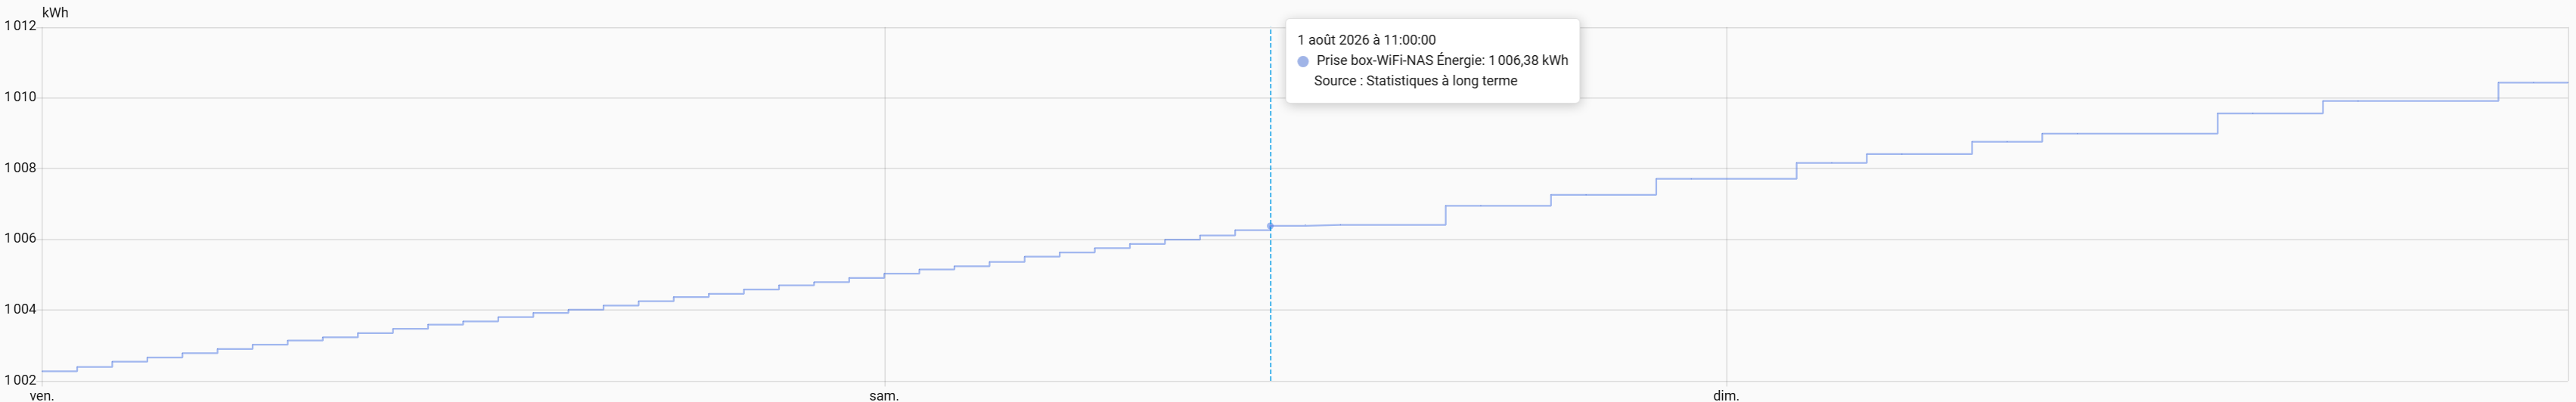
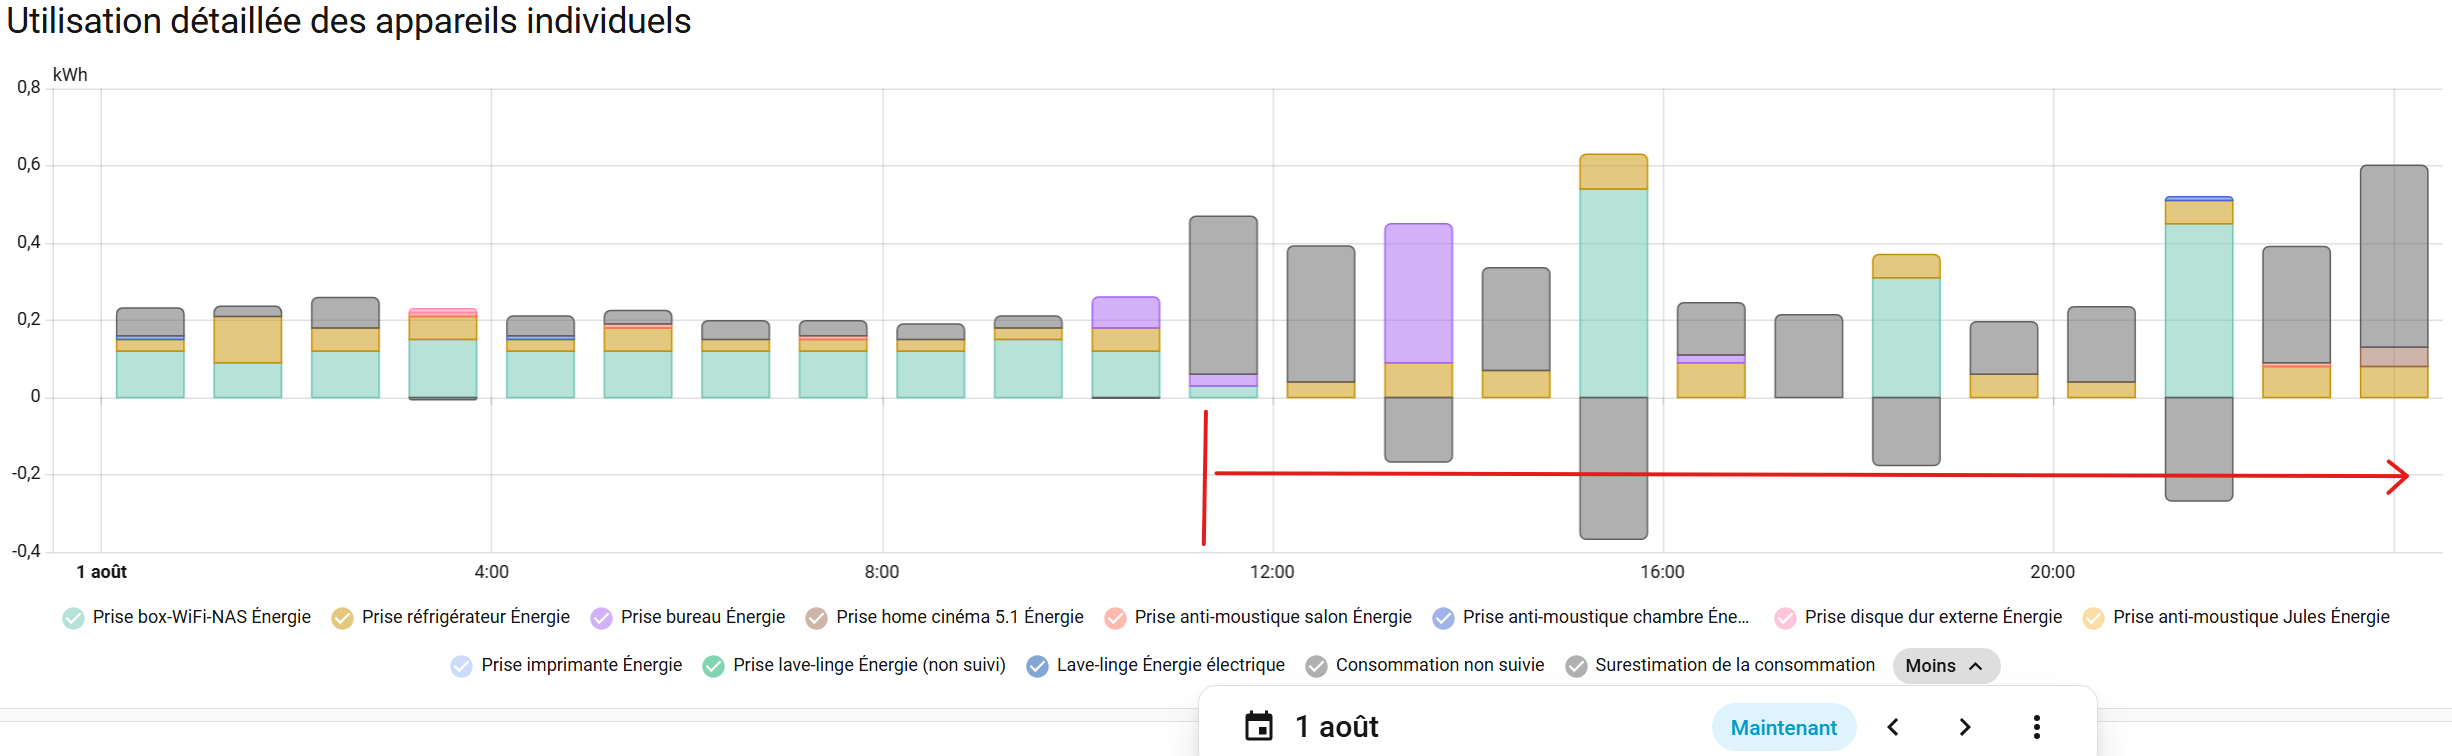
Cela fait quelques jours que j'ai remarqué que l'index de consommation (énergie) d'au moins 2 prises (Girier JR-ZPM01) sur 8 remonte de manière plus espacée qu'avant, à intervalles plus longs, et ce depuis le 1er août à 11h. Je suspecte donc en 1er lieu que ce soit suite à la màj de Z2M en 2.13.0-1. Avez-vous remarqué également un comportement similaire chez vous ? :
Ma configuration
System Information
| version |
core-2026.8.3 |
| installation_type |
Home Assistant OS |
| dev |
false |
| hassio |
true |
| docker |
true |
| container_arch |
amd64 |
| user |
root |
| virtualenv |
false |
| python_version |
3.14.6 |
| os_name |
Linux |
| os_version |
6.18.39-haos |
| arch |
x86_64 |
| timezone |
Europe/Paris |
| config_dir |
/config |
Home Assistant Cloud
| logged_in |
false |
| can_reach_cert_server |
ok |
| can_reach_cloud_auth |
ok |
| can_reach_cloud |
ok |
HACS
| GitHub API |
ok |
| GitHub Content |
ok |
| GitHub Web |
ok |
| HACS Data |
ok |
| GitHub API Calls Remaining |
5000 |
| Installed Version |
2.0.5 |
| Stage |
running |
| Available Repositories |
4084 |
| Downloaded Repositories |
5 |
Home Assistant Supervisor
| host_os |
Home Assistant OS 18.2 |
| update_channel |
stable |
| supervisor_version |
supervisor-2026.07.5 |
| agent_version |
1.10.0 |
| docker_version |
29.6.2 |
| disk_total |
30.8 GB |
| disk_used |
21.6 GB |
| nameservers |
2a02:8424:9d61:7a01::1, 192.168.1.1 |
| healthy |
true |
| supported |
true |
| host_connectivity |
true |
| supervisor_connectivity |
true |
| ntp_synchronized |
true |
| virtualization |
kvm |
| board |
ova |
| supervisor_api |
ok |
| version_api |
ok |
| installed_addons |
AirCast (5.2.0), File editor (6.1.0), Mosquitto broker (7.1.0), MyElectricalData (0.13.4), Terminal & SSH (10.4.0), Linky (1.8.0), Gazpar2HAWS (0.5.1a1), Music Assistant (2.9.13), Matter Server (9.2.0), Z-Wave JS UI (7.5.0), Z-Wave JS (1.7.1), Zigbee2MQTT (2.13.0-1) |
Dashboards
| dashboards |
2 |
| resources |
3 |
| views |
2 |
| mode |
storage |
Network Configuration
| adapters |
lo (disabled), enp0s3 (enabled, default, auto), hassio (disabled), docker0 (disabled), veth95d187e (disabled), veth489244a (disabled), veth704655f (disabled), vetha884de1 (disabled), vethab0c515 (disabled), veth1756521 (disabled), veth6d5c60e (disabled), veth9e839a9 (disabled), vethfff85cb (disabled), veth6c3251a (disabled), veth11d2183 (disabled), veth0cdf64c (disabled), veth5e66d79 (disabled), vethc7f67ba (disabled) |
| ipv4_addresses |
lo (127.0.0.1/8), enp0s3 (192.168.1.249/24), hassio (172.30.32.1/23), docker0 (172.30.232.1/23), veth95d187e (), veth489244a (), veth704655f (), vetha884de1 (), vethab0c515 (), veth1756521 (), veth6d5c60e (), veth9e839a9 (), vethfff85cb (), veth6c3251a (), veth11d2183 (), veth0cdf64c (), veth5e66d79 (), vethc7f67ba () |
| ipv6_addresses |
lo (::1/128), enp0s3 (2a02:8424:9d61:7a01:6d96:1669:d1a3:c1aa/64, fe80::7e0f:bee2:e59c:eb13/64), hassio (fd0c:ac1e:2100::1/48, fe80::708c:21ff:fe0b:e31d/64), docker0 (fd92:79ae:2c89::1/64, fe80::e049:82ff:fe05:b0a0/64), veth95d187e (fe80::b479:74ff:fe35:f093/64), veth489244a (fe80::bce2:90ff:fe2d:bac6/64), veth704655f (fe80::7839:33ff:fefe:444e/64), vetha884de1 (fe80::58e7:d3ff:fe59:1f65/64), vethab0c515 (fe80::888d:bfff:fefc:ea3a/64), veth1756521 (fe80::ec0c:f6ff:fe61:56/64), veth6d5c60e (fe80::f010:92ff:febc:d840/64), veth9e839a9 (fe80::101b:27ff:fea3:d0dc/64), vethfff85cb (fe80::70ae:abff:fe0a:3949/64), veth6c3251a (fe80::a41f:4dff:fe48:7947/64), veth11d2183 (fe80::1096:4aff:fedb:885f/64), veth0cdf64c (fe80::23:38ff:fe35:6c1f/64), veth5e66d79 (fe80::641d:21ff:fe0c:1e3/64), vethc7f67ba (fe80::dc89:e2ff:fe98:f29f/64) |
| announce_addresses |
192.168.1.249, 2a02:8424:9d61:7a01:6d96:1669:d1a3:c1aa, fe80::7e0f:bee2:e59c:eb13 |
Recorder
| oldest_recorder_run |
10 août 2026 à 20:23 |
| current_recorder_run |
23 août 2026 à 21:33 |
| estimated_db_size |
438.31 MiB |
| database_engine |
sqlite |
| database_version |
3.53.2 |
___
Je n'ai pas eu de problème de mon côté. Mais vu la façon dont ça se comporte, je parierais plutôt sur un problème d'électronique au niveau de la prise. Regarde ton historique plus en détail pour voir s'il n'y a pas une puissance ou quelque chose comme ça qui est retombée à zéro. Ça pourrait provoquer des valeurs négatives dans l'interprétation de la chose.
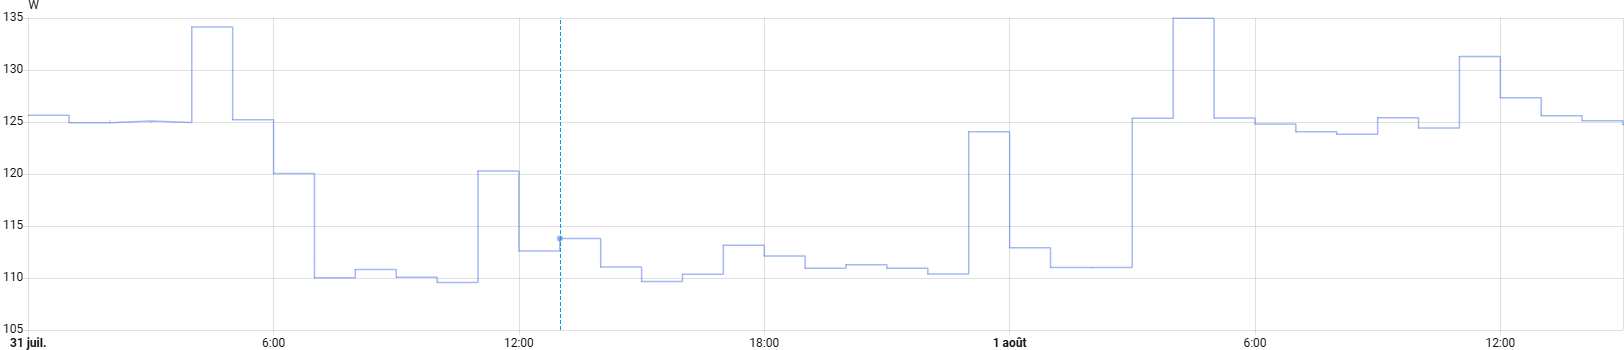
Je ne constate pas d'anomalie au niveau de la puissance (instantanée ?) remontée, celle de la date de l'incident (long term statistics) :
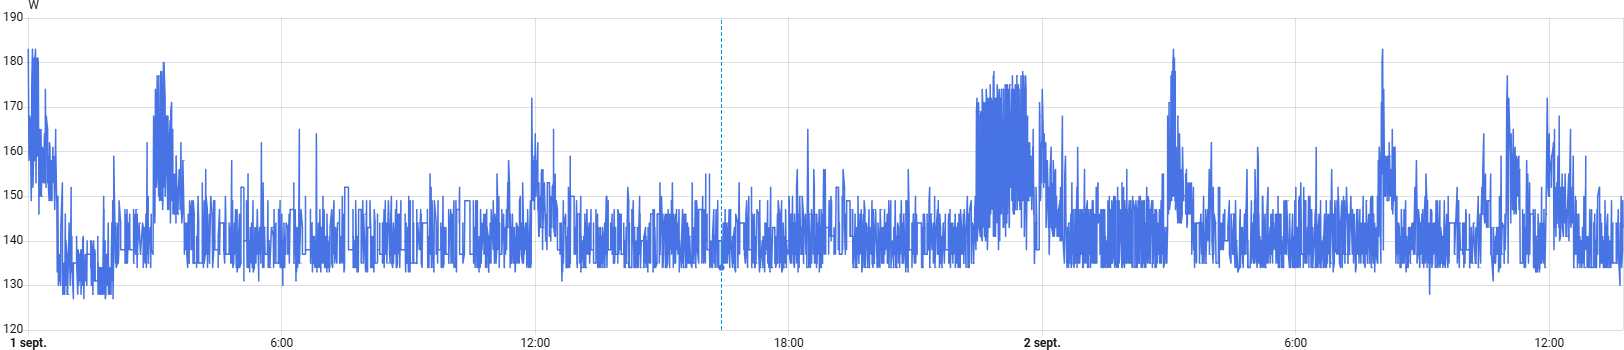
Et le suivi actuel :
J'avais ouvert une Issue dans le GitHub de Z2M, car je n'avais pas trouvé jusqu'à présent un problème similaire au mien, je tente donc la solution de cette utilisateur : Issue · GitHub
Après plusieurs jours, a priori la solution proposée de réduire la valeur d’intervalle de 257 à 10 sur seMetering semble bien fonctionner